2026년 8월 21일 · 약 14분 읽기 · HF 논문 4편 · arXiv 보강 0편 · RSS 뉴스 10건
AI 기술 데일리 리서치
검증 가능한 실행과 인프라 효율이 연구·제품·운영 현장으로 동시에 이동하는 흐름을 살핍니다.
오늘의 데일리 브리핑
모델의 자기평가보다 외부 검증이 중요해지고 있습니다. SemaPLC는 컴파일·실행 흔적을 완료 조건으로 삼고, OpenAI는 고급 안전 처리와 데이터 보존 최소화를 함께 제시했습니다. 둘 다 “생성”보다 감사 가능한 운영 경계를 설계하는 문제입니다.
폐루프 학습의 단위가 넓어졌습니다. Zetta는 로봇 실행 중 비평과 복구 기술을 갱신하고, Co-RL은 서로 다른 모델의 피드백으로 동질화 위험을 낮춥니다. 다만 전자는 물리 환경의 속도 제약, 후자는 동료 모델의 오류 상관성이 핵심 한계입니다.
AI의 병목은 품질과 비용을 함께 측정하는 데 있습니다. SemComp-Bench는 영상의 결과 달성과 의미 정합성을 분리해 평가하고, KT는 AI 데이터센터의 전력·자원 효율을 전면에 두었습니다. 비전문가도 “그럴듯함”과 “목표 달성”을 구분해 볼 필요가 있습니다.
배포 생태계도 재편되고 있습니다. Gemma의 누적 다운로드와 Google의 선호 출처 기능은 모델·검색 양쪽에서 배포 경로의 중요성을 보여 줍니다. 사용량이나 트래픽의 숫자만으로 신뢰도와 지속 가능성을 판단하기는 어렵습니다.
Hugging Face Daily Papers
아래 4편은 2026-08-20 Hugging Face Daily Papers에 게시된 논문입니다. 메타데이터는 arXiv와 교차 확인했습니다.
Hugging Face Daily Papers · 2026-08-20 · HF 논문 페이지 · arXiv
영상 생성의 ‘과업 완료’를 따로 재는 벤치마크 SemComp-Bench: Benchmarking Semantic Task Completion in Video Generation
Keyu Tu 외 6명
쉽게 말하면
영상이 보기 좋게 이어지는지와, 지시한 결과를 실제로 만들었는지는 다른 문제입니다. 이 연구는 기준 이미지와 지시를 바탕으로 목표 결과를 냈는지 따로 측정하는 시험장을 제안합니다.
논문은 무엇을 했나
연구진은 결과 중심 영상 생성 과업을 정의하고, 6개 영역을 포함한 SemComp-Data를 구성했습니다. 각 사례에는 기준 이미지, 상세·간략 지시, 결과 중심 영상이 들어갑니다. 원시 영상을 표준 사례로 바꾸는 4단계 정제 절차도 제시했습니다. 대표 영상 생성 모델을 시험한 결과, 의도한 결과 달성과 과업 관련 의미 정합성을 함께 만족시키는 일은 여전히 어렵다고 보고합니다.
핵심 근거
목표
영상이 지시한 결과를 달성했는지와 기준 이미지의 의미를 유지했는지 평가합니다.
방법
VLM(영상·언어 모델)이 구조화된 이진 질문에 답하는 SemComp-Bench를 사용합니다.
결과
대표 모델들이 두 조건을 동시에 충족하는 데 어려움을 보였습니다.
지표
OA Score는 결과 달성, GR Score는 생성 신뢰도를 뜻합니다. 초록에는 수치 비교가 제시되지 않았습니다.
Hugging Face Daily Papers · 2026-08-20 · HF 논문 페이지 · arXiv
실행 중에 고치는 로봇 에이전트 틀 Zetta ζ: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence
Xin Ding 외 N명
쉽게 말하면
로봇이 일을 끝낸 뒤 반성하는 대신, 움직이는 동안 문제를 감시하고 복구 기술을 제안하게 합니다. 기본 정책은 고정한 채 주변의 비평·복구 장치를 갱신하는 방식입니다.
논문은 무엇을 했나
Zetta는 물리 실행에서 고정 기술을 따르는 기존 개방루프 방식의 한계를 문제로 삼습니다. 행동 주기, 실행 묶음, 검증 기반 기술 갱신으로 나눈 세 시간 규모의 루프를 사용합니다. Z-Infra는 에이전트 논리와 서로 다른 실행 자원을 분리합니다. LIBERO-Pro와 RoboCasa에서 각각 90.8%, 93.6% 성공률과 11.1배 추론 속도 향상을 보고했습니다.
핵심 근거
목표
변하는 로봇 환경에서 실행 중 학습과 복구를 가능하게 합니다.
방법
코드 기반 런타임 비평가와 복구 기술을 온라인으로 진화시킵니다.
결과
자기 탐색 경험이 늘수록 성공이 계속 확장되고, 학습한 기술의 제로샷 전이를 보고했습니다.
지표
LIBERO-Pro 90.8%, RoboCasa 93.6%, 11.1배 추론 속도 향상입니다.
작동 흐름
1. 상태로봇·환경 변화 입력
관찰→
2. 비평실행 중 오류 감시
제안→
3. 복구기술 후보 생성
검증→
4. 갱신통과한 기술만 반영
초록 근거: 행동 주기 제어, 실행 단위 비평·복구 제안, 검증 기반 기술 갱신의 세 루프를 제시합니다.
Hugging Face Daily Papers · 2026-08-20 · HF 논문 페이지 · arXiv
PLC 코드 생성에 외부 검증을 거는 에이전트 SemaPLC: A Project-Grounded, Verification-Gated Agent Harness for PLC Code Generation
Yanlun Tu 외 N명
쉽게 말하면
산업 설비를 제어하는 코드에서는 모델이 “완성했다”고 말해도 충분하지 않습니다. 이 방법은 명세·컴파일·실행 검사를 통과한 기록이 있어야 완료로 처리합니다.
논문은 무엇을 했나
SemaPLC는 기존 PLC 프로젝트 맥락에서 코드를 생성한 뒤, 외부 검증 기록을 완료 조건으로 둡니다. 검사는 명세, 컴파일, 실제 런타임의 동작을 포함합니다. 독립 POU 117개 과업에서 7개 모델의 평균 엄격 검증 통과율은 72.6%였습니다. 실제 프로젝트 안에서 실행 흔적을 비교한 동적 행동 점수는 기준 방식 22.4~31.4보다 SemaPLC 52.2로 크게 분리됐습니다.
핵심 근거
목표
생성한 PLC 논리가 기존 프로젝트에 통합돼 실제로 동작하는지 확인합니다.
방법
명세·컴파일·실행의 외부 검사를 통과할 때만 작업을 끝냅니다.
결과
정적 점수보다 실제 런타임의 동적 행동 검사가 방법 간 차이를 더 뚜렷하게 보였습니다.
지표
평균 엄격 검증 통과율 72.6%, 동적 점수 52.2입니다.
작동 흐름
1. 명세프로젝트 맥락·요구 입력
생성→
2. 코드PLC 논리 작성
검사→
3. 검증컴파일·정적·동적 확인
통과→
4. 완료로그가 남은 작업만 종료
초록 근거: 명세·컴파일·실제 런타임의 외부 검사가 완료 조건을 구성합니다.
Hugging Face Daily Papers · 2026-08-20 · HF 논문 페이지 · arXiv
서로 다른 모델 집단으로 만드는 비지도 추론 Co-RL: Unsupervised Reasoning Emerges from Diverse Cohort in Multi-agent RL
Yunhao Yang 외 N명
쉽게 말하면
모델 하나가 자기 답만 채점하면 같은 실수를 되풀이할 수 있습니다. 서로 다른 모델들이 서로에게 보상을 주게 하면, 정답 라벨 없이도 추론 능력을 키울 수 있다는 주장입니다.
논문은 무엇을 했나
Co-RL은 매개변수를 공유하지 않는 여러 모델을 함께 강화학습으로 최적화하고, 동료의 답에서 보상을 얻습니다. 모델 계열·크기·문항 표현을 다양하게 해 상관된 오류를 줄이는 것이 핵심입니다. 텍스트와 멀티모달 영역에서 기본 모델 및 기존 라벨 없는 방법보다 일관되게 좋았다고 보고합니다. 정답 라벨 없이도 일부 지도학습 방법과 같거나 나은 성능을 보였다는 결과는, 보상 설계의 독립성이 중요하다는 점을 시사합니다.
핵심 근거
목표
사람이 만든 정답 라벨 의존도를 낮추며 추론을 향상합니다.
방법
서로 다른 모델의 피드백을 보상으로 쓰는 다중 에이전트 강화학습입니다.
결과
집단 다양성이 행동 다양성을 유지하고 학습 붕괴를 줄였다고 설명합니다.
지표
텍스트 7개 벤치마크에서 3.0~8.6%, 멀티모달 4개에서 2.3~7.2% 평균 향상입니다.
RSS 뉴스와 읽을거리
국내 3건, 해외 4건, 블로그·Hacker News 3건을 골랐습니다. 각 원문 URL을 직접 요청해 확인했으며, OpenAI 원문은 403으로 상세 확인에 실패했습니다.
AI타임스는 구글의 오픈 모델 Gemma 제품군이 누적 다운로드 10억 건을 넘었다고 보도했습니다. 보도에 따르면 구글 딥마인드는 20일 공식 블로그에서 개발자 커뮤니티의 사용 확대를 알렸습니다. 함께 공개한 ‘Awesome Gemma’ 저장소는 생태계의 프로젝트·자료를 모으는 경로로 소개됩니다. 다운로드 수는 배포 규모를 보여 주지만, 모델 품질이나 실제 도입 성과를 직접 뜻하지는 않습니다.
AI타임스는 웨이모가 로보택시용 자체 칩을 개발해 차량에 적용하기 시작했다고 전했습니다. 보도는 센서 데이터 처리와 AI 기반 주행 판단을 위한 전용 설계를 핵심으로 설명합니다. 이는 자율주행 서비스에서 모델뿐 아니라 지연 시간과 전력 효율을 좌우하는 하드웨어 선택이 중요하다는 사례입니다. 칩 성능이나 배포 범위의 구체적 수치는 원문에서 확인되지 않았습니다.
AI타임스는 과학기술정보통신부가 AI로 사회문제를 해결하는 2026 AI·디지털 챌린지 공모를 추진한다고 보도했습니다. 민간 클라우드에서 AI 에이전트 개발 도구를 지원하고, 바이브 코딩을 통한 서비스 개발 지원도 언급했습니다. 공모는 기술 데모보다 문제 정의와 운영 환경을 연결하는 실험의 기회가 될 수 있습니다. 다만 선정 기준과 지원 범위는 공고 원문을 기준으로 별도 확인해야 합니다.
RSS 설명에 따르면 OpenAI는 적격 API 고객을 위한 Zero Data Retention을 재확인하고, 데이터 프라이버시를 해치지 않는 고급 안전 처리를 예고했습니다. 이 항목의 원문은 직접 요청에서 403 응답을 받아 상세 확인이 불가했습니다. 원문 상세 확인 불가
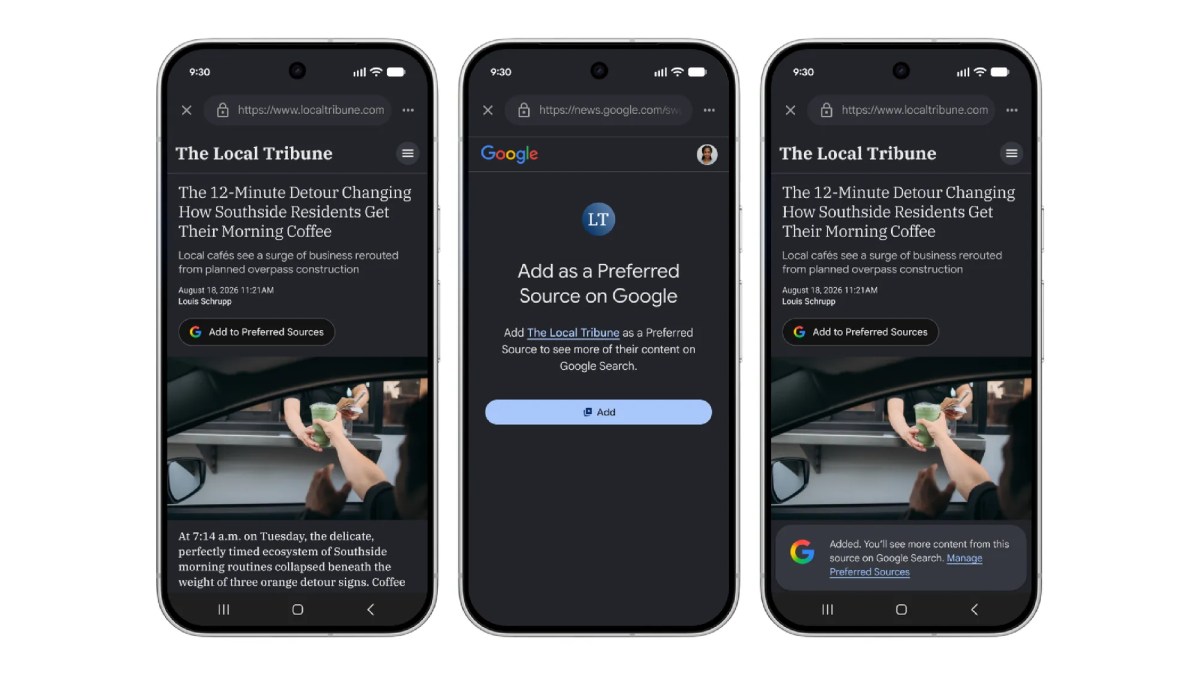
TechCrunch는 Google이 독자가 특정 발행인을 선호 출처로 지정할 수 있는 버튼을 제공한다고 보도했습니다. 지정된 출처는 Search, Discover, Google News에서 더 눈에 띄게 노출될 수 있습니다. 기사는 AI 검색이 웹으로 보내는 클릭을 줄이는 상황을 이 기능의 배경으로 설명합니다. 기능이 실제로 발행인의 트래픽 감소를 얼마나 상쇄할지는 별도 관찰이 필요합니다.
MIT Technology Review는 AI 기업들이 Claude와 ChatGPT의 사용 보고서를 내지만, 공개하는 데이터는 기업이 선택한 일부라는 연구자들의 지적을 전합니다. 제품 로그만으로는 직업·조직·사회적 맥락을 충분히 설명하기 어렵다는 문제가 제기됩니다. 사용량 지표는 편리하지만, 혜택과 위해가 누구에게 어떻게 분배되는지까지 보여 주지는 않습니다. 정책과 제품 결정을 위해서는 독립적이고 재현 가능한 사용 연구가 필요하다는 논지입니다.
ZDNet Korea는 AI 연산 수요 증가로 AI 데이터센터의 경쟁력이 규모만이 아니라 자원·전력 활용 효율에 달렸다고 전했습니다. KT는 차세대 네트워크, CXL, 모듈러 방식을 대응 방향으로 제시했습니다. 이는 모델 성능 개선이 인프라의 메모리·네트워크·전력 병목과 함께 다뤄져야 함을 보여 줍니다. 기사에는 제안 기술별 절감량이나 배포 일정의 비교 수치가 제시되지 않았습니다.
Simon Willison은 AI가 소프트웨어 개발을 바꾸는 방식에 관한 Talking Postgres 팟캐스트 대화를 바탕으로 글을 썼습니다. 글은 코드 생성량이나 줄 수처럼 쉽게 세는 지표가 개발의 품질과 설계 일관성을 대체하지 못한다는 문제를 다룹니다. AI 도구가 생산성을 높이더라도, 시스템의 개념적 일관성을 판단하고 유지하는 책임은 사라지지 않습니다. 팀은 산출량보다 변경이 기존 구조와 맞물리는지를 검토할 기준을 두는 편이 낫습니다.
Hacker News에 공유된 게시물은 EU에서 AI 생성 콘텐츠의 저작권 보호와 관련한 판단을 소개합니다. RSS 항목은 원문 URL과 함께 168포인트, 183개 댓글의 토론 반응을 기록했습니다. 이 항목은 법률 자문이 아니라 커뮤니티에서 주목받은 논의의 신호로 읽어야 합니다. 적용 국가, 인간의 창작적 기여, 구체적 판결문은 공식 법원·규제기관 자료로 확인해야 합니다.
Hacker News에서 주목받은 글은 AI 기업이 물리 도서를 훼손한다는 문제 제기와 희귀 도서 보존을 위한 스캔 주장을 함께 다룹니다. RSS는 해당 글이 275포인트와 205개 댓글을 얻었다고 기록했습니다. 보존 목적의 디지털화와 저작권·접근 권한은 별개의 문제이므로, 주장만으로 합법성이나 사실관계를 단정할 수 없습니다. 데이터 확보 경쟁이 문화유산 보존의 방식과 충돌할 수 있다는 쟁점은 검토할 가치가 있습니다.
검증 메모: RSS 후보를 바탕으로 원문 URL을 직접 요청했습니다. 이미지 4개는 원문 페이지의 공식 og:image를 내려받아 로컬 경로로 넣었습니다. OpenAI 항목 1건은 403으로 원문 상세 확인에 실패했으며, 그 외 선택 항목은 원문 또는 공개 본문을 확인했습니다.