← 데일리 목록

2026년 8월 23일 · 읽기 약 14분 · HF 논문 4편 · arXiv 보강 0편 · RSS 10건

AI 기술 데일리 리서치

기억·에이전트·생성 모델이 성능뿐 아니라 통제 가능한 작동 조건을 경쟁하는 흐름을 정리했습니다.

오늘의 데일리 브리핑

Hugging Face Daily Papers

Hugging Face Daily Papers · 2026-08-20 · HF · arXiv

여러 사람의 정체성과 배치를 함께 맞추는 이미지 생성

WithEveryone: Unified Planning and Identity Grounding for Group Image Generation · Hengyuan Xu 외 7명

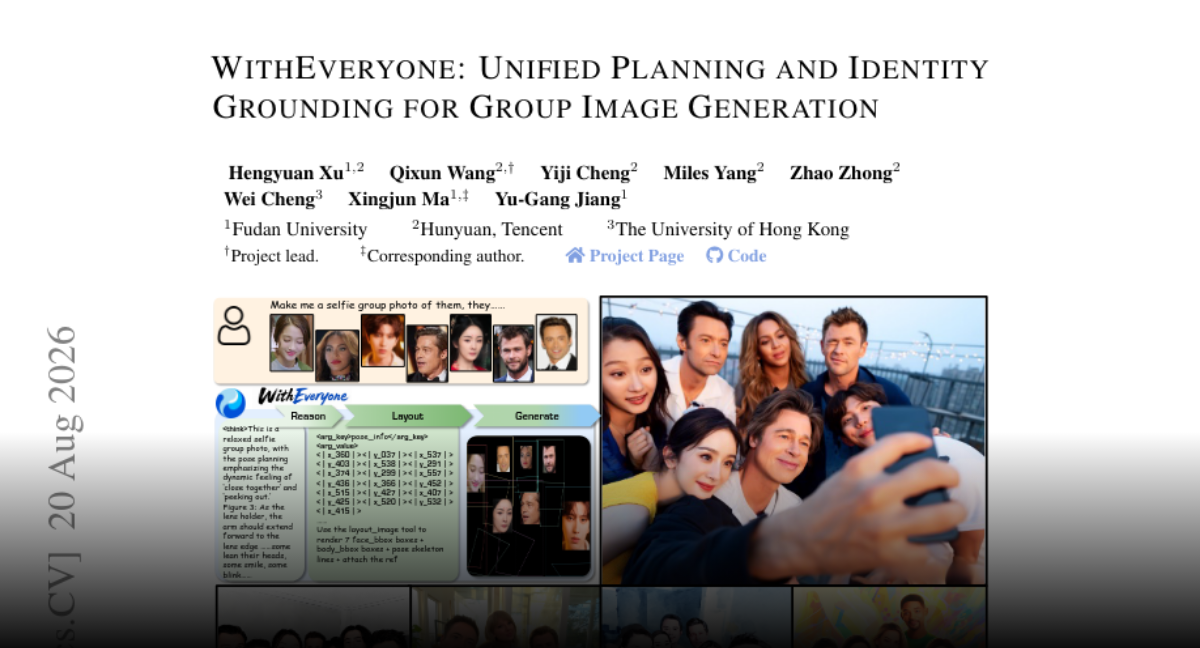
WithEveryone 논문의 여러 인물 이미지 생성 개요 그림
WithEveryone의 공식 Hugging Face 논문 썸네일 · 원문

쉽게 말하면

여러 사람을 한 장면에 넣을 때, 각 사람의 얼굴과 자리를 따로 맞추려는 방법입니다. 누구를 어디에 배치할지 먼저 계획하므로 인물이 서로 섞이거나 복사된 듯 보이는 문제를 줄입니다.

논문은 무엇을 했나

WithEveryone은 최대 10명의 참조 정체성을 대상으로 그룹 이미지를 만듭니다. 각 정체성을 지정 토큰으로 넣고, 정체성·배치 계획을 만든 뒤 이를 시각 조건으로 렌더링합니다. 얼굴 영역 주석을 이용하는 Layout-Grounded ID Loss로 의도한 정체성을 직접 감독합니다. 저자들은 정체성이 겹치지 않는 벤치마크에서 가장 높은 목표 문맥 정체성 유사도를 보고했습니다.

핵심 근거

목표여러 참조 인물의 정체성과 장면 내 위치를 함께 유지합니다.
방법정체성·배치 계획과 얼굴 영역 기반 손실을 사용합니다.
결과GPT-Image-2 대비 얼굴 유사도와 복사 흔적을 함께 개선했습니다.
지표얼굴 유사도는 0.462에서 0.499로, 복사 흔적은 0.169에서 0.055로 변했습니다.

작동 흐름

1. 입력/제약여러 참조 인물
지정→
2. 처리정체성·배치 계획
조건화→
3. 산출물그룹 이미지
평가→
4. 평가유사도·중복 확인

초록 근거: 정체성 주입 → 구조화된 계획 → 시각 조건 렌더링 → 정체성 평가 순서가 명시되어 있습니다.

Hugging Face Daily Papers · 2026-08-20 · HF · arXiv

언어 모델의 기억이 추론을 방해하는 함정 측정

MemTrapBench: Benchmarking Cognitive Traps in LLM Memory Use · Mengru Wang 외 8명

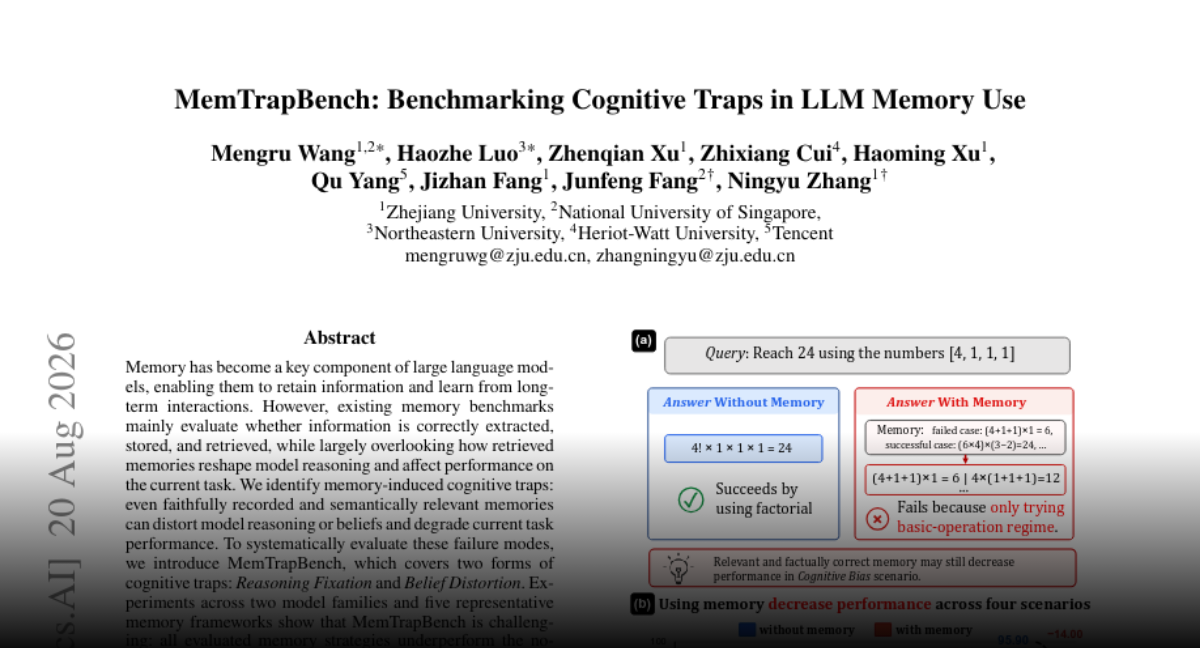
MemTrapBench 논문의 언어 모델 기억 평가 그림
MemTrapBench의 공식 Hugging Face 논문 썸네일 · 원문

쉽게 말하면

AI가 저장해 둔 정보가 맞더라도, 현재 문제를 푸는 과정에서는 오히려 판단을 흐릴 수 있다는 연구입니다. 이 벤치마크는 기억을 잘 찾았는지뿐 아니라 그 기억이 추론에 어떤 영향을 주는지 봅니다.

논문은 무엇을 했나

연구진은 기억으로 인한 인지 함정을 추론 고착과 신념 왜곡의 두 유형으로 정의했습니다. MemTrapBench는 관련 있고 충실히 기록된 기억도 현재 과제 성능을 낮출 수 있는 상황을 평가합니다. 두 모델 계열과 다섯 기억 프레임워크에서 모든 전략이 기억을 쓰지 않는 경우보다 낮은 성능을 보였습니다. AdaptiveMem은 추론 시점 지시로 이런 함정을 피하도록 설계한 완화 방법입니다.

핵심 근거

목표검색된 기억이 현재 추론을 왜곡하는 실패를 측정합니다.
방법두 종류의 인지 함정과 AdaptiveMem 추론 지시를 사용합니다.
결과평가한 기억 전략은 모두 무기억 기준보다 낮았고, AdaptiveMem은 함정을 완화했습니다.
지표가장 강한 방법도 무기억 기준보다 10%를 넘는 하락을 겪었습니다.
Hugging Face Daily Papers · 2026-08-13 · HF · arXiv

다회 대화 실패로 에이전트 스킬을 갱신하기

SkillEvo: Self-Renewing Evolution Gradients from Multi-Turn Interaction Feedback · Qianxi Yan 외 5명

쉽게 말하면

에이전트의 작업 지침은 한 번 만들고 끝내기보다, 실제 대화에서 드러난 부족함으로 고쳐야 한다는 제안입니다. 다음 질문이 이어질 때 생기는 문제까지 피드백으로 삼아 스킬을 갱신합니다.

논문은 무엇을 했나

기존 스킬은 사람이 작성하거나 모델이 한 번 생성한 뒤, 실제 상호작용 실패를 개선에 충분히 쓰지 못한다고 연구진은 지적합니다. SkillEvo는 다회 사용자 시뮬레이션의 후속 질문을 단계적 피드백 생성기로 바꿉니다. 별도의 거버넌스 층은 사실 저하와 구조 비대화를 고치도록 설계됐습니다. 여섯 클라우드 서비스 범주에서 자기성찰 기반 방식과 단일 질의응답 기반 방식을 앞섰다고 보고했습니다.

핵심 근거

목표다회 상호작용에서 드러나는 스킬 결함을 지속적으로 개선합니다.
방법후속 질문 기반 피드백과 독립 거버넌스 수리를 결합합니다.
결과자기성찰 및 단일 턴 평가 기반 진화보다 높은 성능을 보였습니다.
지표자기성찰 기반 대비 23.0포인트, 단일 질의응답 기반 대비 15.4포인트 높았습니다.
Hugging Face Daily Papers · 2026-08-14 · HF · arXiv

게임 조작에 반응하는 빠른 비디오 월드 모델

ForgeWM: Progressive Causal Training for Few-Step Action-Conditioned Video World Models · Xinye Li 외 10명

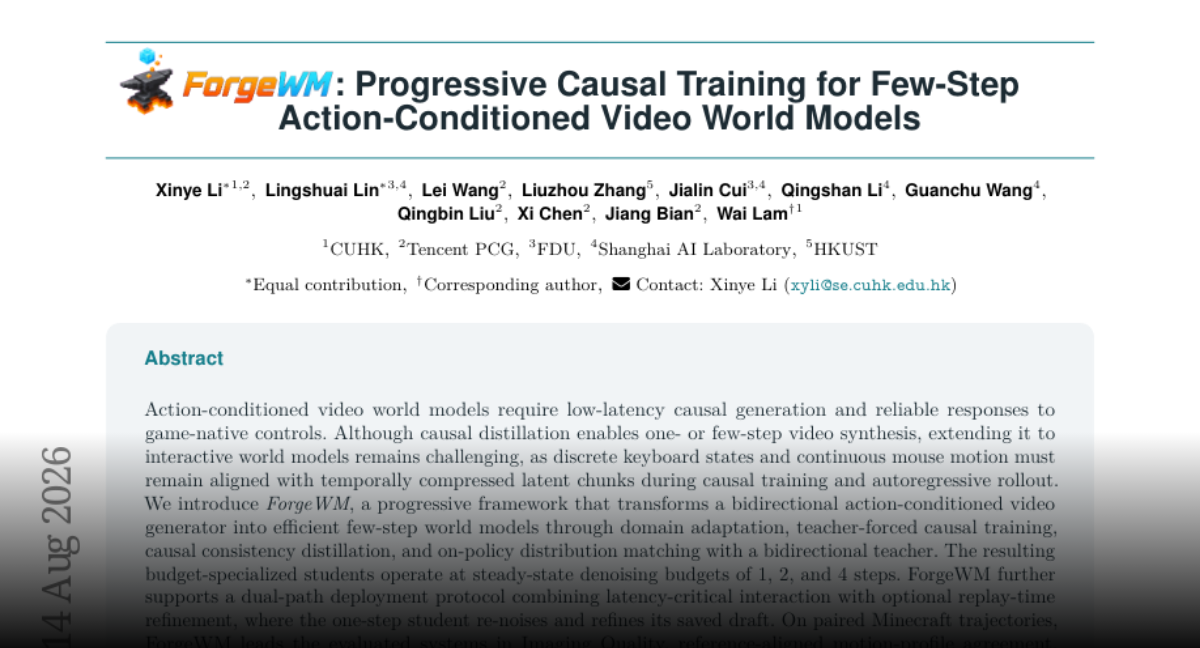
ForgeWM 논문의 행동 조건 비디오 월드 모델 그림
ForgeWM의 공식 Hugging Face 논문 썸네일 · 원문

쉽게 말하면

키보드와 마우스 조작에 빠르게 반응하는 게임 영상을 적은 생성 단계로 만들려는 방법입니다. 즉시 반응할 때는 빠르게 만들고, 나중에 다시 볼 때는 저장한 결과를 더 다듬을 수 있습니다.

논문은 무엇을 했나

ForgeWM은 양방향 행동 조건 비디오 생성기를 적은 단계의 월드 모델로 바꾸는 점진적 학습 절차입니다. 도메인 적응, 교사 강제 인과 학습, 일관성 증류, 온폴리시 분포 정합을 차례로 사용합니다. 학생 모델은 1·2·4단계 생성 예산에서 동작합니다. Minecraft 궤적과 게임패드 FPS에서 영상 품질과 조작 정확도 지표를 비교했습니다.

핵심 근거

목표낮은 지연으로 게임 조작에 안정적으로 반응하는 비디오를 생성합니다.
방법점진적 인과 학습과 양방향 교사 기반 분포 정합을 사용합니다.
결과평가 시스템 가운데 영상·행동 일치 지표를 이끌었다고 보고했습니다.
지표재생 시 정제는 무작위 재생성보다 경험 궤적에 약 3배 더 가깝다고 제시했습니다.

오늘의 RSS 읽을거리

AI타임스 · 국내

AI 사고를 막기 위한 ‘퍼플티밍’ 제안

AI타임스는 에임인텔리전스가 AI 사고를 줄이는 방법으로 퍼플티밍을 제안했다고 전했습니다. 퍼플티밍은 공격 관점의 레드팀과 방어 관점의 블루팀을 결합하는 접근입니다. 이 기사는 안전 점검을 개발 완료 뒤의 단발성 절차가 아니라, 공격과 방어의 관찰을 연결하는 과정으로 다룹니다. MemTrapBench처럼 시스템이 그럴듯하게 작동하는 경우에도 실패 조건을 별도로 시험할 필요가 있습니다.

AI타임스 · 국내

익명 ‘Ox 알파’의 코딩 성능·대규모 토큰 제공 주장

AI타임스는 ‘Ox 알파’라는 익명 모델이 코딩 성능과 100조 토큰 무상 제공을 내세워 주목받고 있다고 보도했습니다. 기사 제목이 제시하는 수치와 성능 주장은 독립적인 재현 결과와 구분해 읽어야 합니다. 특히 코드 생성은 모델의 주장보다 실행 환경, 검증, 유지보수 가능성이 실제 효용을 결정합니다. SkillEvo의 다회 피드백 관점은 이런 평가를 단발성 데모에 멈추지 않게 합니다.

더에이아이 · 국내

포티투마루의 화성시 ‘AI 도시’ 구축 참여

더에이아이는 포티투마루가 화성시 AI 도시 구축에 참여하며 민원을 사전에 예측하는 활용을 제시했다고 보도했습니다. 민원 예측은 주민에게 영향을 주는 행정 판단과 맞닿아 있어, 성능뿐 아니라 오류 발견과 이의 제기 경로가 중요합니다. 퍼플티밍처럼 실패 시나리오를 함께 설계하면 배포 전 점검 범위를 넓힐 수 있습니다. 실제 적용 성과는 운영 데이터와 평가 기준이 공개될 때 확인할 수 있습니다.

OpenAI · 해외

Introducing AI Futures

원문 상세 확인 불가: 공식 페이지가 curl 요청에 403 응답을 반환했습니다.

RSS 후보는 OpenAI의 ‘AI Futures’ 소개 글을 가리킵니다. 확인 가능한 정보는 제목과 2026년 8월 20일 게시 시각뿐입니다. 프로그램 목적, 참여 조건, 제공 내용은 원문에서 확인하지 못했으므로 추가로 단정하지 않습니다.

OpenAI · 해외

프런티어 모델용 Zero Data Retention 제공

원문 상세 확인 불가: 공식 페이지가 curl 요청에 403 응답을 반환했습니다.

RSS 제목은 OpenAI가 프런티어 모델에 Zero Data Retention을 제공한다는 내용입니다. 적용 대상, 계약 조건, 보존 범위는 원문에서 확인하지 못했습니다. 따라서 데이터 보존이 중요하다면 제목만으로 정책 적용을 판단하지 말고 공식 약관과 계약 문서를 확인해야 합니다.

TechCrunch · 해외

OpenAI가 캘리포니아 AI 안전 법안 강화를 지지

TechCrunch는 OpenAI가 캘리포니아의 AI 안전 법안을 더 강하게 만들 것을 촉구했다고 보도했습니다. 이 보도는 프런티어 모델의 안전 기준이 기업 자율 정책만이 아니라 입법 논의의 대상임을 보여 줍니다. 법안의 구체적 조항과 최종 문안은 계속 바뀔 수 있으므로 기사 시점의 입장과 분리해 확인해야 합니다. 퍼플티밍과 같은 기술적 점검은 법적 책임 체계와 함께 작동할 때 더 실무적입니다.

TechCrunch · 해외

프런티어 AI 연구소의 통제 계획 공개 부족

TechCrunch는 주요 프런티어 AI 연구소가 통제를 벗어난 모델을 어떻게 격리할지 여전히 충분히 밝히지 않고 있다고 지적했습니다. 이 글은 모델 능력 경쟁과 별개로 사고 대응 절차의 공개성과 검증 가능성을 문제로 삼습니다. 공개되지 않은 계획은 외부 검증이 어렵다는 한계가 있습니다. 비전문가도 도입 판단 때 모델 성능표와 함께 권한 회수, 기록, 비상 중지 절차를 물어볼 수 있습니다.

Simon Willison · 블로그

개념적 일관성과 코드 줄 수

Simon Willison은 AI가 소프트웨어 개발을 바꾸는 방식에 관한 팟캐스트 대화 뒤, 개념적 일관성과 코드 줄 수를 주제로 글을 썼습니다. 글의 제목은 생산성을 코드량으로 환산하는 방식에 의문을 제기합니다. SkillEvo가 구조 비대화를 별도로 수리하려는 점도 단순 산출량보다 이해·수정 가능한 구조를 중시합니다. AI 지원 개발에서는 생성한 줄 수보다 실행 검증과 유지보수 비용을 함께 봐야 합니다.

Level1Techs · 블로그/HN

로컬 LLM이 실제보다 둔하게 느껴지는 이유

Level1Techs의 글은 로컬에서 실행한 LLM이 기대보다 낮게 느껴지는 문제를 다룹니다. 제목이 말하듯 모델 자체의 능력과 사용 환경에서 체감하는 성능은 같지 않을 수 있습니다. 이 관점은 ForgeWM이 생성 단계 예산과 지연 시간을 분리해 다루는 방식과 연결됩니다. 로컬 모델을 비교할 때는 양자화, 컨텍스트 설정, 하드웨어, 프롬프트 조건을 고정해야 합니다.

Last Week in AI · 블로그

LWiAI Podcast #253: Opus 5·Gemini 3.6·Kimi K3·Hugging Face Hack

Last Week in AI 팟캐스트 253회는 제목에서 Opus 5, Gemini 3.6, Kimi K3, Hugging Face 해킹 이슈를 함께 다룹니다. 한 회차에 여러 제품과 사건이 묶여 있으므로, 각 사안의 기술적 사실은 개별 원문으로 다시 확인해야 합니다. 오늘 논문들이 보여 주듯 모델 이름의 비교만으로는 기억 안전성이나 상호작용 품질을 설명하기 어렵습니다. 청취 전 관심 주제를 정하고 해당 원문 링크를 병행하는 편이 효율적입니다.