2026년 8월 25일 · 약 12분 · HF 논문 5편 · arXiv 보강 0편 · 뉴스 11건
AI 기술 데일리 리서치
에이전트는 더 오래 일하도록, 모델은 더 작은 기기에서 돌도록 설계가 이동하고 있습니다.
오늘의 데일리 브리핑
작업을 오래 이어 가는 구조가 공통 화두입니다. InfinityEdit은 다음 영상 구간까지 편집을 이어 가고, Graph Engineering은 여러 에이전트의 역할과 상태를 그래프로 관리하자고 제안합니다. OpenAI의 범용 에이전트 확대 보도도 같은 흐름이지만, 실제 사용에서는 권한 설계가 함께 따라와야 합니다.
명시적인 제약과 검증이 성능과 신뢰를 함께 겨냥합니다. EviRank는 검색 조건을 항목별 증거로 바꾸고, PhysCaP은 로봇이 직접 만져 보며 보이지 않는 물성을 확인합니다. 둘 다 단순히 더 큰 모델을 쓰기보다, 판단 근거를 구조화합니다.
배포 비용은 제품의 일부가 되고 있습니다. Llama-Mobile은 11B 시각언어 모델을 3.7GB로 줄였고, 국내에서는 맥북에서 구동하는 Qwen 변형 모델 사례가 나왔습니다. 다만 압축이나 안전 제약 완화는 품질과 안전성 검증을 별도로 요구합니다.
비전문가의 실무 관찰: AI가 일을 대신하는 범위가 넓어질수록, 결과물 자체보다 어떤 데이터·도구·권한을 썼는지 기록하는 절차가 중요해집니다. 교육 현장의 신호등 규칙과 Instinct의 개인정보 우려는 이를 사용자 경험의 문제로 보여 줍니다.
Hugging Face Daily Papers
Hugging Face Daily Papers · 2026-08-21 · Enjun Du 외 9명 · 소속 미표기
증거를 조립해 이미지 검색 순서를 다시 매기는 방법
EviRank: Structured Relevance Evidence for Multimodal Image Re-ranking
쉽게 말하면
사진을 찾을 때 “이 셔츠는 유지하고 색만 분홍으로”처럼 여러 조건을 한꺼번에 확인하게 만드는 방식입니다. 모델이 막연히 비슷하다고 판단하는 대신, 필요한 조건과 제외할 조건을 목록으로 만들어 후보를 점검합니다.
논문은 무엇을 했나
EviRank는 텍스트·이미지·둘을 섞은 검색 질의를 여섯 종류의 의미 항목으로 분해합니다. 각 항목에는 필수, 금지, 무시 여부를 붙이고, 후보 이미지를 항목별 채점과 후보 간 비교로 다시 정렬합니다. 학습 없이 작동하도록 설계했으며, 필요하면 이 명시적 증거를 가벼운 학생 모델의 학습 자료로 쓸 수 있습니다. 저자들은 다섯 개 검색 벤치마크에서 최고 성능을 보고했습니다.
핵심 근거
목표복합적인 이미지 검색 조건을 빠뜨리지 않고 반영합니다.
방법구조화한 증거 항목, 규칙 기반 채점, 목록 단위 비교를 결합합니다.
결과다섯 벤치마크에서 최고 성능을 보고했습니다.
지표경량 학생 모델은 교사 능력의 90% 이상을 유지했다고 보고했습니다.
작동 흐름
1. 입력복합 검색 질의
분해
2. 제약필수·금지 조건
검증
3. 산출물후보 재정렬
평가
4. 평가검색 벤치마크
초록 근거: 질의를 증거 패키지로 파싱하고, 증거 조건부 검증으로 재정렬한 뒤 다섯 벤치마크에서 평가합니다.
Hugging Face Daily Papers · 2026-08-21 · Yunze Tong 외 11명 · 소속 미표기
끝없이 이어지는 영상 편집 어댑터
InfinityEdit: Infinite Video Editing with a Lightweight Edit-Ignition Adapter
쉽게 말하면
짧은 영상 한 조각을 고치는 데서 멈추지 않고, 라이브처럼 계속 들어오는 다음 장면에도 같은 편집 요청을 이어 가려는 연구입니다. 새 편집 요청이 들어온 구간에만 가벼운 장치를 켜고, 이후 장면은 원래 생성기가 계속 만들도록 나눕니다.
논문은 무엇을 했나
기존 지시 기반 영상 편집은 정해진 길이의 원본을 프레임마다 고치는 경우가 많았습니다. InfinityEdit은 이전 영상과 편집 요청을 받아 다음 구간을 계속 생성하는 ‘무한 영상 편집’ 설정을 정의합니다. 이를 위해 이력, 시간 인과성, 편집 정보를 다루는 세 가지 어텐션 모듈을 가진 경량 어댑터를 제시했습니다. 저자들은 반복되는 편집 요청에서도 연속성과 안정성을 보였다고 설명합니다.
핵심 근거
목표열린 길이의 영상 흐름에 편집을 연속 적용합니다.
방법이력 교차 어텐션, 시간 인과 자기 어텐션, 편집 교차 어텐션을 사용합니다.
결과편집 후에도 영상 흐름을 충실히 이어 가고 안정성을 유지했다고 보고했습니다.
지표초록은 수치 대신 무한 편집 시퀀스에서의 안정적 생성 결과를 제시합니다.
작동 흐름
1. 입력이전 구간·편집 요청
주입
2. 처리세 가지 어텐션
생성
3. 산출물다음 영상 구간
반복
4. 평가연속성·안정성
초록 근거: 편집 요청 구간에 어댑터를 활성화하고, 이후 구간은 기준 프레임을 초기화해 원 모델이 생성합니다.
Hugging Face Daily Papers · 2026-08-21 · Chen-Yu Lin 외 10명 · 소속 미표기
로봇이 만져 보고 물성을 알아내는 정책 에이전트
PhysCaP: Grounding Code-as-Policy Agent with Physics-Informed Exploration
쉽게 말하면
눈으로만 보면 알기 어려운 물체의 무게나 단단함을 로봇이 직접 만져 보고 알아내게 합니다. 필요한 만큼만 탐색하도록 계획 담당과 우선순위 담당을 나누어, 불필요한 동작을 줄이려 했습니다.
논문은 무엇을 했나
시각언어행동 정책은 시연을 모방하는 데 강하지만, 숨은 물성은 수동 관찰만으로 알기 어렵습니다. PhysCaP은 로봇의 내부 감각 정보에서 무게와 강성을 추정하는 학습 없는 모듈을 추가했습니다. 계획 에이전트가 탐색의 시작과 종료를 결정하고, 우선순위 에이전트가 불가능한 상호작용을 걸러냅니다. 실제 탁상 조작과 LIBERO 시뮬레이션에서 적은 상호작용과 짧은 실행 시간으로 비교 가능한 성능을 보고했습니다.
핵심 근거
목표숨은 물성이 있는 조작 작업에서 능동 탐색을 수행합니다.
방법물리 정보 추출, 탐색 계획, 상호작용 우선순위화를 결합합니다.
결과수동·단순 상호작용 기준선보다 적은 상호작용으로 비교 가능한 성능을 보고했습니다.
지표상호작용 횟수와 실행 시간이 줄었다고 보고했으며 초록에는 정확한 수치가 없습니다.
작동 흐름
1. 입력물체·작업 목표
탐색
2. 처리물성 추정·선별
실행
3. 산출물조작 코드 정책
평가
4. 평가실물·시뮬레이션
초록 근거: 상호작용으로 물성을 추정하고, 두 에이전트가 탐색을 결정·우선순위화한 뒤 조작 과제를 평가합니다.
Hugging Face Daily Papers · 2026-08-21 · Luka Ribar 외 2명 · 소속 미표기
휴대기기용 시각언어 모델 2.7비트 양자화
Llama-Mobile: Efficient 2.7-Bit Quantization of VLMs
쉽게 말하면
사진을 보고 질문에 답하는 큰 모델을 휴대기기에서도 돌릴 수 있게, 표현에 쓰는 숫자의 정밀도를 크게 낮춘 방법입니다. 학습 원본을 다시 구하지 못해도 모델이 스스로 만든 데이터로 압축 과정을 진행합니다.
논문은 무엇을 했나
시각언어 모델은 메모리와 연산 요구량이 커서 모바일 배포가 어렵습니다. 이 연구는 모델 자체가 생성한 학습 데이터와 Arm CPU 실행을 고려한 파라미터당 2.7비트 형식을 결합했습니다. Llama 3.2 11B Vision Instruct를 8비트 활성화 조건에서 3.7GB로 압축했습니다. 저자들은 표준 시각 질의응답 과제에서 강한 성능을 보존했다고 보고합니다.
Hugging Face Daily Papers · 2026-08-21 · Yuyuan Feng 외 32명 · 소속 미표기
LLM 에이전트를 그래프로 설계하는 관점
Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence
쉽게 말하면
여러 AI 에이전트가 함께 일할 때, 누가 무엇을 하고 현재 일이 어디까지 왔는지를 그래프로 명시하자는 제안입니다. 에이전트 수만 늘리는 대신 작업·역할·상태의 연결 관계를 계속 갱신해 관리합니다.
논문은 무엇을 했나
저자들은 장기 과제에서 단일 에이전트의 조직 능력에는 한계가 있다고 봅니다. 복수 전문성, 병렬 실행, 독립 검증, 지속 상태가 필요한 경우에는 시스템 수준의 조정이 필요하다는 주장입니다. 이를 ‘시스템 지능’으로 부르고, 작업·에이전트·시스템 상태를 나타내는 동적 그래프를 중심에 둡니다. 이 논문은 해당 패러다임의 원리·방법론·응용을 체계적으로 검토하는 서베이입니다.
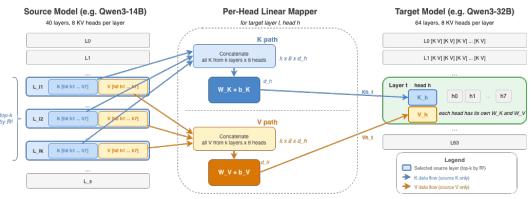
AI타임스는 여러 모델을 번갈아 쓰는 장시간 에이전트 작업에서 모델 전환 시 KV 캐시 전송이 비용과 지연을 만든다고 보도했습니다. 기사에 따르면 엔비디아는 이 전송을 선형 연산으로 처리하는 방법을 제시했습니다. 라우팅 구조가 복잡해질수록 모델 성능뿐 아니라 상태를 옮기는 비용도 운영 성능을 좌우한다는 점을 보여 줍니다.
AI타임스는 Qwen 3.8 27B를 바탕으로 안전성 제약을 크게 줄인 변형 모델이 공개됐다고 전했습니다. 기사 설명은 애플 실리콘의 통합 메모리를 활용해 엔비디아 GPU나 클라우드 없이 구동하는 사례에 초점을 둡니다. 로컬 실행 가능성은 비용과 데이터 통제 측면에서 의미가 있지만, 안전 제약을 낮춘 모델의 사용 범위와 검증은 별도로 판단해야 합니다.
ZDNet Korea는 플로바 에이아이가 에이전트 네이티브 영상 제작 워크플로에 Seedance 2.5를 통합했다고 보도했습니다. 기사에는 100여 가지 재사용 가능한 스킬, 프로젝트 메모리, 제작 자동화가 함께 언급됩니다. 개별 생성 모델 경쟁보다 제작 과정 전체를 반복 가능한 작업 흐름으로 묶으려는 제품 방향으로 읽을 수 있습니다.
TechCrunch는 초기 사용자가 Instinct의 기능을 높게 평가하는 한편, 넓은 접근 권한과 이용 약관, 사용자를 대신해 행동하는 기능을 우려한다고 보도했습니다. 기사는 편의성이 커질수록 권한의 범위와 책임 소재가 불편한 교환 조건이 될 수 있다고 짚습니다. 에이전트를 도입할 때는 기능 목록보다 접근 가능한 계정·데이터·실행 권한을 먼저 확인해야 합니다.
TechCrunch는 OpenAI가 소프트웨어 엔지니어 중심의 에이전트를 더 넓은 사용자층으로 확장하려는 움직임을 분석했습니다. 제목이 던지는 핵심 질문은 에이전트를 다양한 업무에 만들 수 있는지보다, 사람들이 실제로 맡길 것인지입니다. 이는 Graph Engineering처럼 시스템을 조직하는 연구와 맞물리지만, 대중 사용에서는 신뢰와 권한 통제가 채택의 조건이 됩니다.
MIT Technology Review는 한 학교가 과제에서 AI를 써도 되는 시점을 신호등 비유로 설명한다고 소개했습니다. 핵심은 AI를 일괄 금지하거나 전면 허용하는 대신, 과제의 목적에 따라 사용 가능 범위를 구분하는 것입니다. 비전문가 조직에서도 에이전트의 권한을 단계별로 나누는 방식에 참고가 될 수 있습니다.
Simon Willison은 AI가 소프트웨어 개발을 바꾸는 상황에서 코드 줄 수를 세는 관행과 개념적 일관성을 논의했습니다. RSS 설명에 따르면 이 글은 Talking Postgres 팟캐스트에서 나눈 대화를 바탕으로 합니다. 코드가 빨리 늘어나는 환경일수록, 구성 요소가 같은 원칙으로 작동하는지 검토하는 일이 더 중요해진다는 문제 제기입니다.
Simon Willison은 알리바바 Qwen 연구팀의 Apache 2.0 라이선스 27B 시각 지원 모델인 Qwen 3.8 27B를 다뤘습니다. 글의 제목처럼 저자는 성능을 높게 보면서도 기본 설정이 지나치게 오래 생각하는 경향을 지적합니다. 이는 모델 선택에서 최고 품질뿐 아니라 응답 시간과 추론 비용을 함께 조절해야 한다는 실무적 기준을 보여 줍니다.
Simon Willison은 LLM 0.32를 초기 출시 이후 가장 큰 변화라고 소개했습니다. RSS 설명과 글의 메타데이터에 따르면 이 버전은 보이는 추론 흔적, OpenAI Responses, 서버 측 도구, 개선된 로깅을 지원합니다. 모델 호출을 제품 기능으로 연결할 때 실행 과정과 기록을 함께 다루려는 흐름으로 볼 수 있습니다.
Simon Willison은 2026-07-28 Model Context Protocol 사양을 중심으로 Stateless MCP에 다시 관심을 갖게 된 배경을 설명했습니다. 글은 이를 MCP 2.0의 배포일로도 부르며, 더 형식적인 사양이라는 점을 언급합니다. 에이전트 도구 연결에서 상태를 어디에 두고 어떻게 재현할지 정하는 일은 기능 추가만큼 중요한 운영 선택입니다.