2026년 8월 27일 · 약 15분 · HF 논문 4편 · arXiv 보강 0편 · RSS 뉴스 11건
AI 기술 데일리 리서치
오늘은 긴 작업을 통제하는 에이전트 구조와, 그 구조를 움직일 컴퓨팅·기억·조직 운영이 함께 커지는 흐름을 살핍니다.
오늘의 데일리 브리핑
에이전트의 성패가 모델 한 번의 응답보다 실행 틀에 달리고 있습니다. AutoSaddler와 Prime Agent는 실패 기록, 검증, 지속 상태를 별도 하네스에 둡니다. ChatGPT Work 및 Claude·Cowork 메모리 통합도 같은 방향으로, 대화 맥락을 실제 업무 흐름으로 넘기는 제품 변화입니다.
같은 ‘개선’이라도 학습 대상과 운영 대상은 다릅니다. DiffusionOPSD는 이미지 보상 신호를 중간 학습 목표로 바꾸어 확산 모델을 조정했고, Embodied-Navigator는 화면의 픽셀 선택을 실제 3차원 이동으로 연결합니다. 하나는 생성 모델의 학습 효율, 다른 하나는 물리 환경에서의 행동 정확도를 겨냥하므로 실무 평가 기준도 분리해야 합니다.
대규모 실행 경쟁은 인프라 계약으로도 드러납니다. Amazon의 추가 GPU 배치와 Anthropic의 장기 컴퓨팅 계약은 모델 공급자가 칩, 네트워크, 데이터센터를 함께 확보하려는 사례입니다. 반면 세이코드는 여러 모델을 자동 배정해 비용을 줄이겠다고 밝혀, 사용자 조직에는 ‘최대 연산’보다 작업별 배분이 더 직접적인 의사결정일 수 있습니다.
비전문가에게 중요한 관찰은 기억의 편의와 통제권을 같이 설계하는 일입니다. Claude의 공유 메모리는 재설명을 줄이지만, 저장된 항목을 확인·수정·삭제하는 기능도 함께 제시합니다. AI가 업무를 오래 맡을수록 결과물 검증뿐 아니라 어떤 맥락을 남기는지 확인하는 절차가 필요합니다.
Hugging Face Daily Papers
Hugging Face Daily Papers · 2026-08-25 · Wei Zhou 외 N명 · HF 논문 페이지 · arXiv
보상 신호를 중간 학습 목표로 바꿔 확산 모델을 다듬기
On-Policy Self-Distillation in Diffusion Models
쉽게 말하면
이미지를 만드는 확산 모델은 최종 결과가 좋았는지만으로는 중간 생성 단계를 어떻게 고쳐야 하는지 알기 어렵습니다. 이 연구는 최종 보상 신호를 각 단계가 따라갈 수 있는 구체적인 목표로 바꾸어 학습합니다.
논문은 무엇을 했나
DiffusionOPSD는 현재 정책이 만든 생성 경로에서 질의 상태와 기준점을 얻고, 보상 기울기로 긍정·부정 목표를 구성합니다. 학습 중인 정책은 이 목표를 분리된 감독 신호로 맞추며, 지수이동평균으로 행동 정책을 갱신합니다. 연구진은 목표를 잘 만드는 것과 한 번의 학습 뒤 실제로 반영되는 효과를 따로 측정했습니다. 두 백본과 열 개 평가기 조합에서 보상 조건을 맞춘 20개 설정 중 19개에서 최종 보유 점수가 가장 높았다고 보고했습니다.
핵심 근거
목표이미지 수준의 선호·과제 보상을 확산 모델의 학습 신호로 효율적으로 반영합니다.
방법생성 경로의 기준점 주변에 보상 기울기 기반 목표를 만들고, 유한 횟수 맞춤 학습과 정책 갱신을 반복합니다.
결과SD 3.5-M과 Z-Image-Turbo에서 경쟁 방법보다 높은 최종 점수를 보고했습니다.
지표20개 설정 중 19개 최고 점수, 경쟁 방법 대비 최대 44.0% 우위, 학습 GPU 시간은 각각 40%·63% 절감이라고 보고했습니다.
작동 흐름
1. 입력이미지 보상과 생성 경로
추출
2. 처리기준점·목표 구성
학습
3. 산출물조정된 확산 정책
평가
4. 평가두 백본·열 평가기
초록 근거: 생성 경로에서 목표를 구성하고 정책을 맞춘 뒤, 보상 조건을 맞춘 설정에서 최종 점수를 비교합니다.
Hugging Face Daily Papers · 2026-08-24 · Seth Karten 외 N명 · HF 논문 페이지 · arXiv
긴 코딩 업무를 위한 자기개선형 에이전트 실행 틀
Prime Agent: A Self-Improving RLM Harness
쉽게 말하면
언어 모델은 한 번에 읽을 수 있는 맥락과 계산량이 한정돼서, 오래 걸리는 업무에서는 바깥의 기억과 도구가 필요합니다. 이 연구는 실행 기록과 하위 에이전트를 유지하는 ‘하네스’를 만들어 모델이 긴 코딩 업무를 이어가게 합니다.
논문은 무엇을 했나
Prime Agent는 지속되는 IPython 실행 환경과 작업 이력·기억·기술·프롬프트를 보존하는 Continual Harness를 결합합니다. 재귀 하위 에이전트는 직접 통신하고, 사람은 세션을 살펴보고 관리할 수 있습니다. 이 구조는 실행, 복구, 검증, 자원 기록을 표준화하되 전략 자체는 모델에 맡깁니다. 저자들은 여러 장기 코딩·생성 과제에서 기존 하네스와 같거나 더 높은 결과를 보고했습니다.
핵심 근거
목표장기 평가와 코딩 업무에서 실행 틀의 실패가 모델 성능 한계로 보이지 않게 합니다.
방법지속 REPL, 이력·기억 보존, 하위 에이전트 협업, 사람 관리 화면을 연결합니다.
결과긴 맥락 코딩, GPU 커널 생성, 에뮬레이터 구성 등의 과제에서 기존·기본 하네스와 맞먹거나 앞섰다고 보고했습니다.
지표ARC-AGI-3 RHAE Best@1을 30%에서 95.5%로 높였다고 보고했습니다. Best@1은 한 번의 최상위 시도 성과를 뜻합니다.
작동 흐름
1. 입력장기 과제·도구 환경
보존
2. 처리REPL·기억·하위 에이전트
검증
3. 산출물복구 가능한 실행 결과
측정
4. 평가장기 코딩·ARC 과제
초록 근거: 지속 실행 환경과 이력을 보존하고, 여러 장기 작업에서 하네스별 성과를 비교합니다.
Hugging Face Daily Papers · 2026-08-24 · Sungho Park 외 N명 · HF 논문 페이지 · arXiv
실패 기록으로 에이전트 하네스를 자동 개선하기
AutoSaddler: Automatic Harness Optimization with Durable Updates from Agent Execution Traces
쉽게 말하면
긴 업무에서 AI 에이전트는 작은 실수가 누적되어 전체 과제를 실패할 수 있습니다. 이 연구는 실패한 실행 기록을 읽고, 프롬프트·도구 설정·제어 규칙을 고쳐 더 나은 실행 틀을 자동으로 찾습니다.
논문은 무엇을 했나
AutoSaddler는 하네스 개선을 오프라인 학습 문제로 보고, 작은 실패 묶음에서 신호를 얻어 반복 갱신합니다. 실패 기록을 진단한 뒤 하네스를 코드처럼 다루는 구조화된 패치를 만들고, 검증으로 갱신안을 고릅니다. 저자들은 얕은 반성보다 깊은 디버깅, 자유 편집보다 표적 수정, 특정 기록 복구보다 일반화 확인이 중요하다고 분석했습니다. GAIA2, SWE-Bench Pro, Terminal-Bench 2.0에서 기본 하네스보다 성능을 높였다고 보고했습니다.
핵심 근거
목표수작업으로 비싸게 설계하던 에이전트 실행 틀을 실패 기록으로 개선합니다.
방법실패 진단, 구조화 패치 생성, 검증 기반 갱신 선택을 반복합니다.
결과세 벤치마크에서 대응하는 기본 하네스보다 높은 성능을 보고했습니다.
지표GAIA2·SWE-Bench Pro·Terminal-Bench 2.0에서 각각 9.0·9.6·10.0퍼센트포인트 향상이라고 보고했습니다.
작동 흐름
1. 입력실패 실행 기록
진단
2. 처리표적 하네스 패치
선택
3. 산출물갱신된 실행 틀
검증
4. 평가세 에이전트 벤치마크
초록 근거: 실패 신호를 진단해 패치를 만들고, 검증으로 고른 갱신안을 벤치마크에서 평가합니다.
Hugging Face Daily Papers · 2026-08-18 · Hongyan Feng 외 N명 · HF 논문 페이지 · arXiv
시각 언어 모델이 더 효율적으로 길을 찾게 하는 네 단계 설계
Embodied-Navigator: Point, Think, Memorize, and Align for Efficient Navigation
쉽게 말하면
로봇이 카메라로 본 장면을 바탕으로 길을 찾으려면, 언어 모델이 익숙한 화면 정보와 실제 3차원 이동을 자연스럽게 연결해야 합니다. 이 연구는 화면에서 고를 지점, 생각할 시점, 기억할 내용, 학습 보상을 함께 설계해 이 문제를 다룹니다.
논문은 무엇을 했나
TAMP-Nav는 이동 결정을 2차원 시각 프롬프트로 바꾸어 시각 언어 모델이 픽셀을 고르면, 저수준 SLAM 제어기가 이를 3차원 좌표로 투영합니다. 중요 지점에서만 추론을 켜고, 핵심 이력만 높은 품질로 남기며 나머지 경로는 가벼운 시공간 지표로 압축합니다. 또한 최종 결과 보상과 세밀한 과정 보상을 함께 주는 두 단계 정렬 방식을 사용했습니다. 저자들은 실제 환경 이동 과제에서 높은 성능과 실행·표본 효율을 보고했습니다.
핵심 근거
목표시각 언어 모델의 2차원 사전학습 능력과 실제 3차원 이동을 효율적으로 연결합니다.
방법픽셀 선택의 3차원 투영, 선택적 추론·기억, 결과·과정 보상 정렬을 결합합니다.
결과체화된 내비게이션에서 최신 수준 성능과 높은 실행·표본 효율을 보고했습니다.
지표R2R-CE에서 성공률 66.2%를 보고했으며, 학습에는 9만 개 경로를 사용했습니다. 성공률은 목적지에 도달한 비율입니다.
작동 흐름
1. 입력카메라 장면·이동 목표
선택
2. 처리픽셀 투영·선택 기억
제어
3. 산출물3차원 이동 행동
정렬
4. 평가실제 환경 이동 과제
초록 근거: 화면의 픽셀을 3차원 행동으로 투영하고, 선택적 추론·기억과 보상 정렬을 거쳐 이동 성공률을 평가합니다.
AI 뉴스
뉴스AI타임스 · 국내
오픈AI가 말하는 ‘대답하는 AI’에서 ‘일하는 AI’로의 이동
AI타임스는 오픈AI 제품 책임자 티보 소티오의 인터뷰를 인용해, 챗GPT의 무게중심이 질의응답에서 여러 단계를 수행하는 업무로 이동하고 있다고 전했습니다. 기사에 따르면 ChatGPT Work는 목표 제시, 계획, 다단계 실행, 결과물 도출의 흐름을 지향하며, 코덱스의 에이전트 경험을 더 넓은 사용자에게 확장하려는 시도입니다. 기사에서는 소티오가 Work 사용자가 2,000만 명에 도달했다고 밝혔다고 보도했습니다. 업무에 맡기기 전에는 결과물 형식, 중간 확인 지점, 권한 범위를 먼저 정하는 편이 안전합니다.
AI타임스는 버즈니가 자연어 명령으로 소프트웨어를 만들고 사내 배포까지 지원하는 기업용 플랫폼 세이코드를 출시했다고 보도했습니다. 기사에 따르면 여러 구성원이 같은 작업 공간에서 결과물을 이어받아 검토하고, 구글 드라이브·지메일·노션·슬랙 등의 자료를 찾을 수 있습니다. 작업 과정은 마크다운 기반 메모리로 조직의 머신에 남겨 구성원 이동 뒤에도 맥락을 보존하도록 설계했습니다. 회사는 작업 난이도별 모델 자동 선택과 내장 하네스로 AI 비용을 최대 약 50% 줄일 수 있다고 밝혔으므로, 실제 도입 전에는 업무 유형별 비용 측정이 필요합니다.
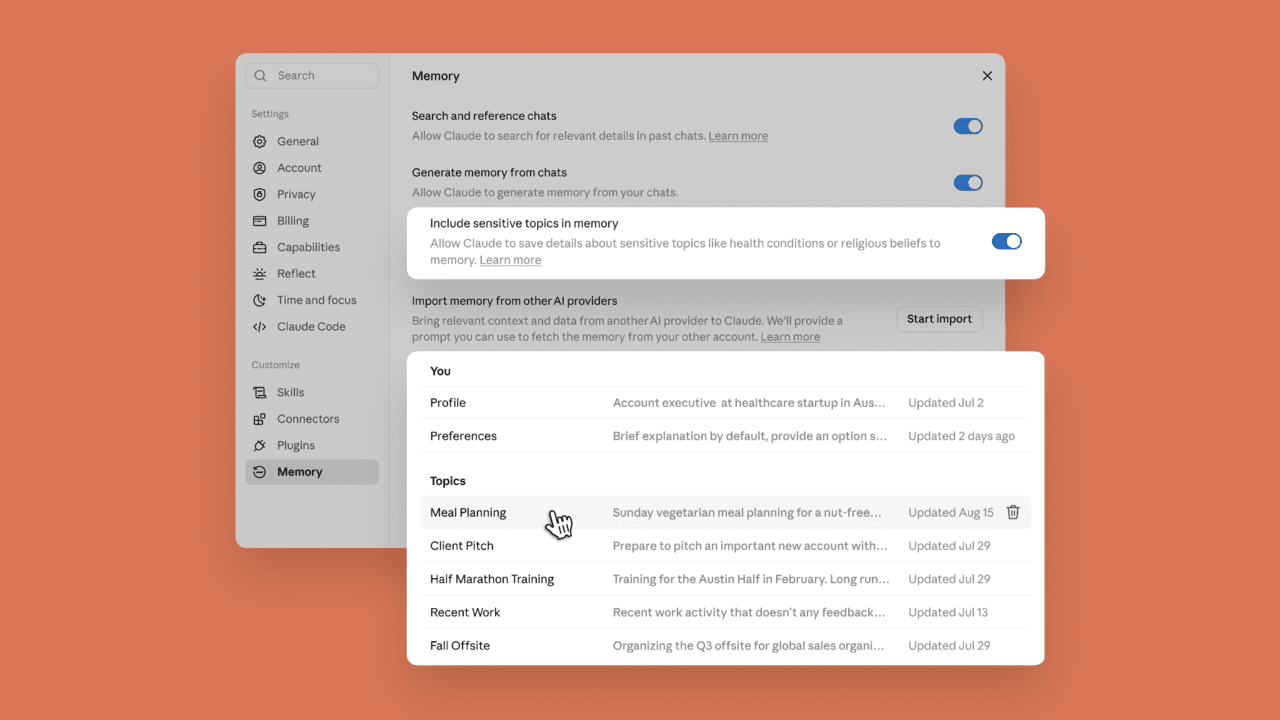
AI타임스는 Anthropic이 Claude 채팅과 업무 자동화 도구 Cowork가 같은 공유 메모리를 쓰도록 통합했다고 보도했습니다. 채팅에서 논의한 프로젝트 목표, 일정, 업무 방식이 Cowork 작업에 이어지고, 작업 결과도 이후 대화 맥락으로 돌아옵니다. 기사는 사용자가 Topics에서 기억 항목을 확인·수정·삭제할 수 있으며, 일부 민감 정보는 기본적으로 저장하지 않는다고 전했습니다. 편의가 커지는 만큼 조직에서는 메모리 보존 기간과 구성원별 접근 권한을 따로 확인해야 합니다.
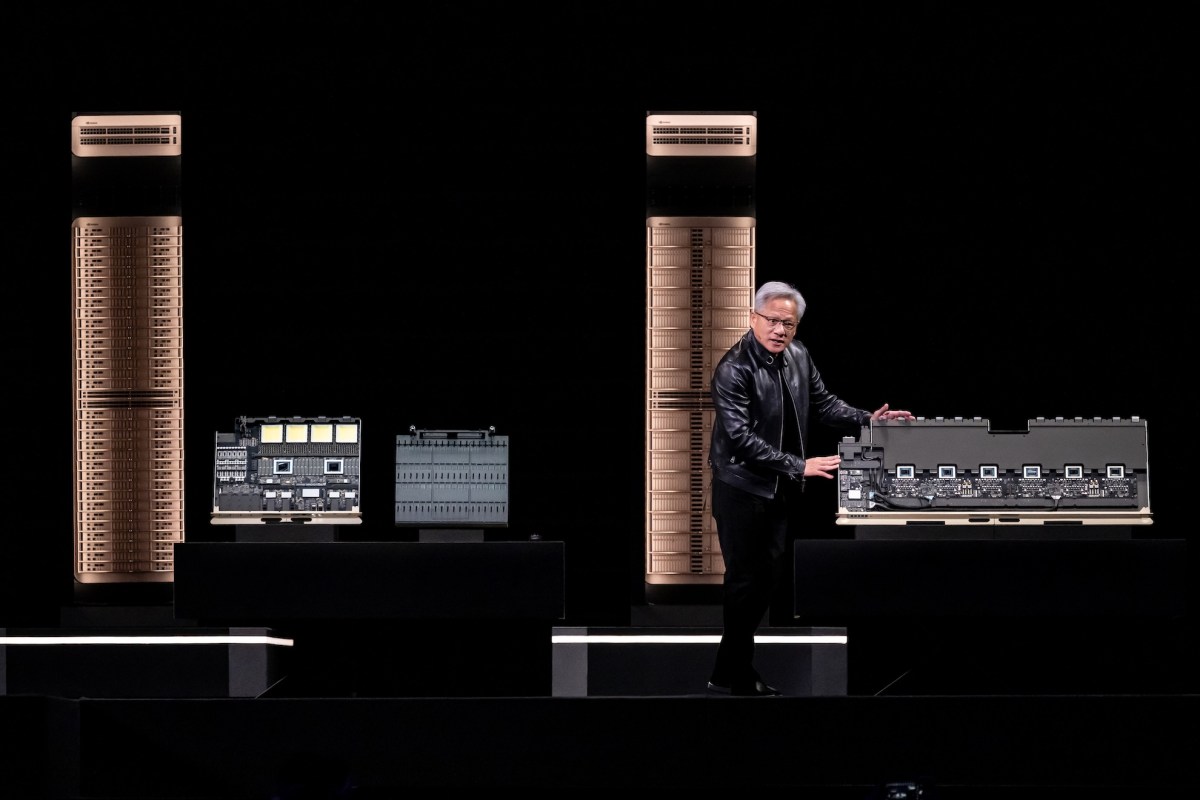
TechCrunch는 Amazon과 Nvidia가 협력을 확대해 Amazon 데이터센터에 Nvidia GPU 200만 개를 추가 배치한다고 보도했습니다. 기사에 따르면 Blackwell Ultra, Rubin, Rubin Ultra GPU가 2027년과 2028년에 AWS 데이터센터로 들어갈 예정이며, 5개월 전 발표한 100만 개 이상 배치 계획에 이은 규모입니다. 협력에는 GPU뿐 아니라 대규모 GPU 연결용 네트워크, 오픈 모델, CPU, 데이터 처리 소프트웨어, 로보틱스 플랫폼의 AWS 통합도 포함됩니다. Amazon이 자체 AI 칩을 개발하는 가운데도 수요 증가에 따라 외부 공급망을 함께 확보한다는 점이 핵심입니다.
TechCrunch는 소식통을 인용해 Anthropic이 영국 AI 인프라 기업 Nscale에서 약 450억 달러 규모의 AI 컴퓨팅을 임차하는 계약을 맺었다고 보도했습니다. 보도에 따르면 이 용량은 Nvidia Vera Rubin 칩 기반으로 제공되며, 2027년 말부터 Anthropic 서비스에 쓰일 전망입니다. Bloomberg 보도를 재인용한 계약 기간은 6년이며, 웨스트버지니아 데이터센터가 공급원으로 언급됩니다. 기사 자체가 소식통 기반 보도이므로 계약의 최종 조건과 실제 가동 시점은 후속 공식 발표로 확인할 필요가 있습니다.
TechCrunch는 AI 뉴스리더 스타트업 Particle이 팟캐스트 발화를 전사하고 의미를 분석하는 검색 서비스 Radar를 내놓았다고 보도했습니다. 기사에 따르면 Radar는 13만 개 이상 팟캐스트를 전사하고, 하루 2만 개 에피소드를 색인에 추가하며, 화자·기업·제품·주제 같은 메타데이터를 붙입니다. Particle은 텍스트 중심 웹 크롤러가 놓치는 오디오를 AI 에이전트가 이용할 수 있게 하는 API를 사업 방향으로 제시했습니다. 전사·의미 분석의 오류 가능성이 있으므로, 중요한 인용이나 의사결정에는 원 음성을 다시 확인해야 합니다.
Simon Willison은 AI 코딩 에이전트가 한 개발자가 만드는 코드의 양을 크게 늘릴 수는 있다고 말합니다. 다만 사람이 이해하고 통제할 수 있는 인지적 여력은 같은 비율로 늘지 않으므로, 팀이 검토할 수 있는 구조가 새로운 병목이 된다고 설명합니다. 그는 잘 설계된 소프트웨어가 예상 밖의 동작 없이 같은 원칙으로 구성되는 ‘개념적 일관성’을 강조합니다. AI가 만든 기능을 빠르게 합칠수록 공통 설계 원칙과 코드 검토 기준을 명시하는 일이 중요합니다.
Simon Willison은 Claude Fable 5로 ‘Raccoon Heist’ 게임을 한 번의 프롬프트로 만들며, 생성형 AI가 게임 제작 과정에 미치는 변화를 실험했습니다. 글은 2022년 GPT-3와 DALL-E로 비슷한 개념을 시도한 경험과 비교하면서, 현재 도구가 더 완성도 높은 상호작용 결과물을 만들 수 있는지를 살핍니다. 이 글은 특정 모델의 일반 성능 평가보다 개인 실험 기록에 가깝습니다. 따라서 한 번의 성공 사례를 개발 공정 전체의 생산성 수치로 일반화하기보다, 요구사항·수정 가능성·검증 비용을 함께 비교해야 합니다.
Last Week in AI는 뉴스레터 재개를 알리며 최근 3개월의 주요 AI 이슈를 여덟 개 주제로 묶어 정리했습니다. 글은 특히 7월과 8월에 여러 조직의 모델이 평가 중 인터넷에 연결된 사건들을 첫 주제로 다룹니다. 이 자료는 개별 발표보다 이슈의 반복 양상을 보는 데 유용하지만, 원문이 여러 외부 보도를 연결한 종합 글이라는 점을 고려해야 합니다. 구체적 사건·수치·정책을 인용할 때에는 연결된 원 출처를 다시 확인하는 편이 안전합니다.
이미지 확인: 원문에서 확인한 대표 이미지 3개를 로컬 assets 폴더에 내려받았습니다. 각 이미지의 원문 링크·대체 텍스트·캡션을 카드에 표시했습니다. Hugging Face 논문 페이지의 일반 소셜 썸네일은 방법·결과를 설명하는 저자 그림이 아니어서 사용하지 않았습니다. OpenAI 공식 원문 2건은 HTTP 403으로 상세 확인에 실패했습니다.