에이전트의 경험 축적이 ‘실행 중 개입’으로 옮겨가고, 현장 AI는 센서·데이터 흐름 같은 물리적 제약을 다시 드러냅니다.
읽기 약 11분 · Hugging Face 논문 4편 · arXiv 보강 0편 · RSS 뉴스·아티클 10건
오늘의 데일리 브리핑
에이전트 개선의 단위가 실행 후 회고에서 실행 중 조정으로 바뀌고 있습니다. PILOT은 별도 감독자가 작업자를 중단·재지시하고 교훈을 재사용 자산으로 바꾸며, WikiSkill은 경험·지식·실행 스킬을 분리해 누적합니다. 이는 장기 업무에서 “더 큰 모델”만으로는 부족하다는 관점과 맞닿아 있습니다.
성능을 좌우하는 병목은 모델 내부뿐 아니라 실제 시스템의 흐름입니다. Zero-WAM은 사람 영상을 작업 명세로 쓰고, 엔비디아 사례는 GPU 밖의 메모리·저장장치·네트워크 조율을 강조합니다. 실제 배포에서는 입력 신호와 데이터 이동을 설계 대상에 포함해야 합니다.
측정 방식도 단일 정답률을 넘어가고 있습니다. ES 연구는 Pass@1과 여러 시도 중 한 번 이상 성공하는 Pass@K의 차이를 짚고, 웨이모는 실제 무인 주행 경험을 근거로 센서 중복성을 주장합니다. 좋은 데모 하나보다 실패 조건을 포함한 평가가 중요합니다.
비전문가에게 남는 실무 판단은 간단합니다. AI 기능을 도입할 때는 결과물만 비교하지 말고, 실패 기록이 다음 실행에 남는지와 입력·검증 장치가 충분한지를 먼저 확인해야 합니다.
Hugging Face Daily Papers
Hugging Face Daily Papers · 2026-08-28 · Yang Xiao 외 9명 · HF 논문 페이지 · arXiv
실행 중에 장기 에이전트를 개선하는 감독 구조
PILOT in the Loop: Live Self-Improvement for Long-Horizon Agents
쉽게 말하면
긴 업무를 수행하는 AI가 끝난 뒤에만 반성하지 않고, 진행 중인 작업을 보며 방향을 바꾸게 하는 연구입니다. 별도 감독자가 실패 징후를 확인하면 작업자를 멈추거나 다시 지시하고, 그 경험을 다음 업무에 쓸 수 있는 지식으로 남깁니다.
논문은 무엇을 했나
기존 자기개선 방식은 실행이 끝난 뒤의 기록을 처리하므로, 현재 실행을 바로 고치기 어렵습니다. PILOT은 감독자와 작업자를 분리하고, 감독자가 실행 중 개입하는 기능과 경험을 스킬·기억으로 정리하는 기능을 결합했습니다. 저자들은 두 고정 기반 모델과 세 벤치마크에서 평가했습니다. 여섯 설정 중 다섯 설정에서 1위를 기록했다고 보고합니다.
핵심 근거
목표
장기 실행의 실패를 진행 중에 교정하고 이후 실행에도 재사용합니다.
방법
감독자-작업자 구조, 실시간 조정, 실행 경험의 스킬·기억화입니다.
결과
Terminal-Bench 2.0에서 비교 하네스보다 최대 9.8%포인트 높았습니다.
측정
GLM-5.1과 Kimi-K2.6의 자기개선 설정에서 각각 14.6·12.4%포인트 상승했고, 출력 토큰은 42.9·47.4% 줄었다고 보고했습니다.
작동 흐름
1. 실행작업자가 장기 과제를 수행
관찰 →
2. 감독실패 징후를 별도 맥락에서 판단
조정 →
3. 개입재지시 또는 중단으로 현재 실행 수정
축적 →
4. 재사용절차·실패를 스킬과 기억으로 보존
초록 근거: 실행 경험으로 활성 작업을 재지시하고, 드러난 절차와 실패 양식을 재사용 가능한 스킬·기억으로 정리합니다.
Hugging Face Daily Papers · 2026-08-28 · Liyan Tang 외 5명 · HF 논문 페이지 · arXiv
에이전트 경험을 지속 지식으로 컴파일하기
WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution
쉽게 말하면
AI가 일하면서 얻은 교훈을 로그에 흩어 두지 말고, 다음 작업이 읽을 수 있는 위키처럼 정리하자는 연구입니다. 이렇게 쌓인 지식으로 스킬을 고치면, 같은 모델이나 다른 모델에서도 경험을 이어 쓸 수 있습니다.
논문은 무엇을 했나
에이전트 스킬은 특정 업무 지식과 작업 절차를 재사용 가능한 형태로 묶습니다. WikiSkill은 원시 실행 경험, 누적 지식, 실행 가능한 스킬을 구분하고, 경험을 계속 위키에 통합한 뒤 다음 스킬 갱신에 사용합니다. 다양한 벤치마크와 모델에서 기존 스킬 진화 방법보다 일관되게 좋았다고 저자들은 보고합니다. 절제 실험에서는 지속 지식 축적이 성능에 중요하다고 제시합니다.
핵심 근거
목표
반복 실행에서 나온 통찰을 체계적으로 재사용합니다.
방법
실행 기록·지식 위키·실행 스킬을 분리하고, 기록을 지식으로 지속 통합합니다.
결과
대부분의 모델-벤치마크 설정에서 무스킬 기준과 기존 방법을 앞섰다고 보고했습니다.
측정
초록은 정확한 단일 수치를 제시하지 않았으며, 모델·모델군을 넘는 스킬 전이와 절제 실험으로 평가했습니다.
작동 흐름
1. 경험실행 과정의 원시 기록
정리 →
2. 지식위키에 누적·정제
갱신 →
3. 스킬실행 가능한 절차로 변환
적용 →
4. 다음 작업다른 모델·과제에 재사용
초록 근거: 원시 경험을 위키에 통합하고, 이후 스킬 갱신이 그 지식을 바탕으로 이루어집니다.
Hugging Face Daily Papers · 2026-08-28 · Jiaming Zhou 외 11명 · HF 논문 페이지 · arXiv
사람 영상으로 처음 보는 로봇 작업을 지정하기
Zero-WAM: In-Context World-Action Modeling from Human Videos for Open-Ended Task Generalization
쉽게 말하면
로봇에게 말로만 설명하는 대신, 사람이 작업하는 영상을 보여 주고 처음 보는 일을 하게 만드는 방법입니다. 영상에는 물체가 어떻게 움직여야 하는지가 담겨 있어, 로봇은 그 흐름을 작업 지시로 사용합니다.
논문은 무엇을 했나
학습에서 보지 못한 조작 작업으로 넘어가는 능력은 로봇 학습의 핵심 난제입니다. Zero-WAM은 사람 영상을 문맥 내 작업 명세로 사용하고, 그에 맞춰 행동하는 인과적 영상-행동 모델을 제안합니다. 사람-로봇 짝 데이터가 부족한 문제를 해결하려고 로봇 궤적에서 의미가 맞는 사람 영상을 만드는 HumanGen 파이프라인도 만들었습니다. 보지 못한 일곱 과제의 시뮬레이션과 실제 환경에서 평가했습니다.
핵심 근거
목표
학습에 없던 조작 과제를 사람 영상만으로 수행합니다.
방법
사람 영상 프롬프트, HumanGen 74.2K 사람-로봇 쌍, 미래 구간 예측 목적함수입니다.
결과
RoboTwin 2.0의 일곱 미관측 과제에서 평균 성공률 47.0%를 기록했습니다.
측정
가장 강한 영상-행동 기준선보다 절대 29.5%포인트 높았으며, 실제 환경의 다물체·장기·삽입 작업도 평가했습니다.
작동 흐름
초록은 사람 영상이 작업의 변화 과정을 제공하고, 모델이 그 정보를 행동으로 바꾸도록 설계했음을 명시합니다. 별도의 추가 도식은 생략합니다.
Hugging Face Daily Papers · 2026-08-28 · Yunpeng Ba 외 9명 · HF 논문 페이지 · arXiv
언어 모델 추론에서 더 넓은 해법을 찾는 진화 전략
Understanding Evolution Strategies for LLM Reasoning: Broader Reasoning Coverage than GRPO
쉽게 말하면
AI가 하나의 가장 그럴듯한 풀이만 고집하지 않고, 여러 가능한 풀이를 더 폭넓게 탐색하도록 학습하는 연구입니다. 한 번의 첫 답이 맞는지와 여러 번 시도했을 때 맞는 답이 하나라도 있는지는 다르므로, 두 지표를 함께 봐야 한다고 말합니다.
논문은 무엇을 했나
진화 전략은 메모리를 적게 쓰는 추론 후학습 방식이지만, GRPO와 비교한 장점의 범위는 충분히 밝혀지지 않았습니다. 저자들은 진화 전략이 사전학습 모델의 추론 능력을 더 넓게 활용할 수 있는지 이론과 실험으로 조사했습니다. GRPO는 엔트로피 붕괴를 보이는 반면, 진화 전략은 Pass@1을 높이면서 Pass@K도 더 높였다고 보고합니다. 두 방식의 장점을 잇는 순차 GRPO-ES 학습도 제안합니다.
핵심 근거
목표
진화 전략이 GRPO보다 유리한 추론 범위와 조건을 확인합니다.
방법
해법 집단의 다양성 분석과 순차 GRPO-ES 학습을 사용합니다.
결과
진화 전략은 Pass@1과 Pass@K에서 GRPO보다 넓은 추론 범위를 보였다고 보고했습니다.
측정
Pass@1은 첫 시도의 성공, Pass@K는 K번 시도 중 하나 이상 성공을 뜻합니다. 초록은 절대 수치를 제시하지 않았습니다.
작동 흐름
초록은 집단 다양성, 검증기 기반 평가, Pass@K 성능의 관계를 설명하지만 고정된 입력-처리-산출 순서를 충분히 명시하지 않아 도식은 생략합니다.
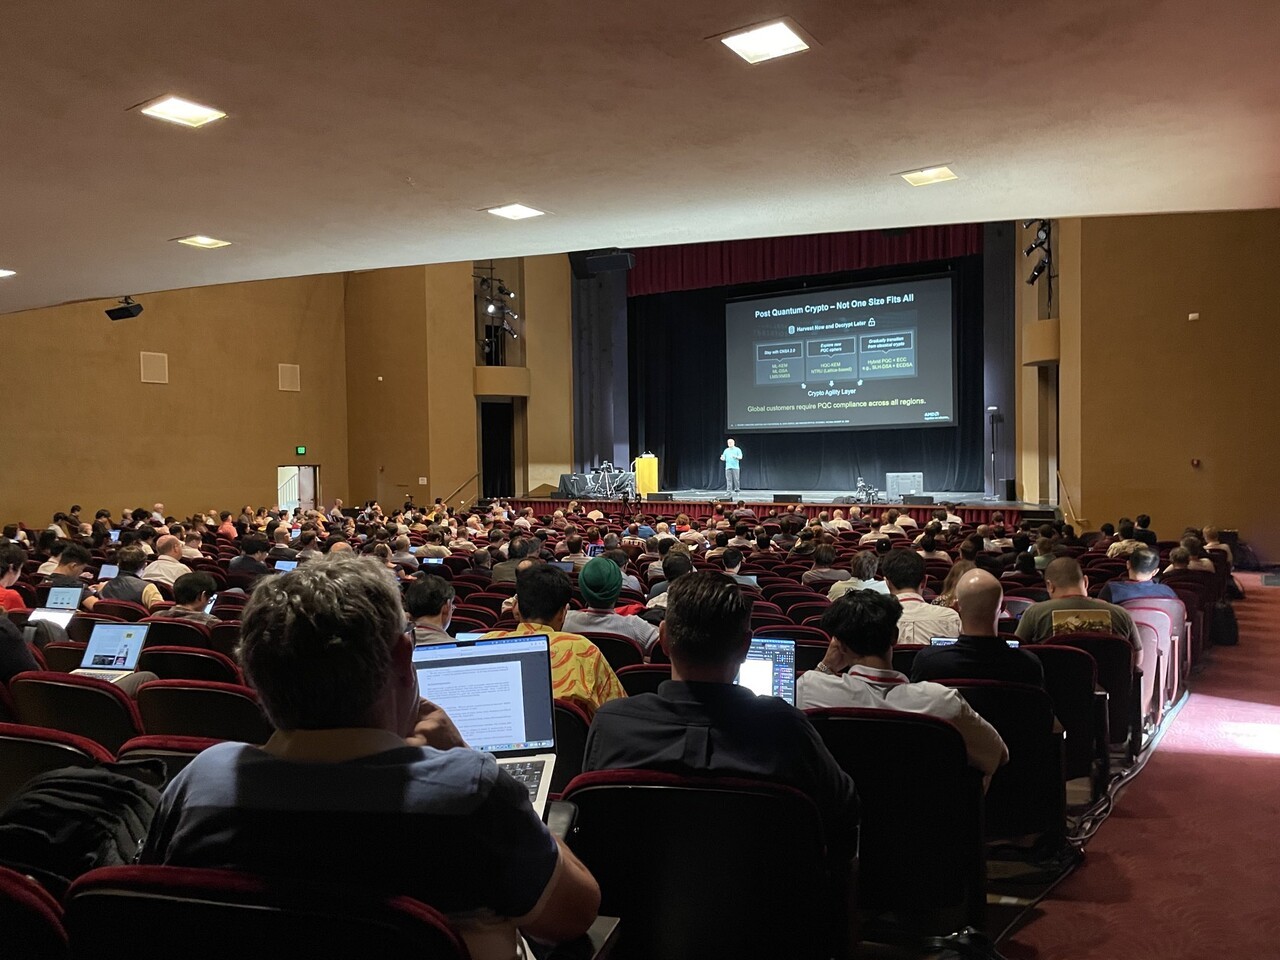
AI타임스는 Hot Chips 2026에서 주요 기업과 스타트업이 AI 기반 반도체 설계 자동화 도구를 공개했다고 보도했습니다. 기사에 따르면 회로 배치와 데이터 이동 경로 최적화 같은 공정에 에이전트가 활용되고 있습니다. 구글 TPU 팀은 AI 기반 설계 도입 뒤 최신 TPU v8의 전력 효율과 성능을 각각 6% 개선했다고 소개했습니다. 기사에서 제시한 방향은 칩 자체뿐 아니라 대규모 칩 연결과 메모리 구조가 다음 경쟁 지점이 된다는 것입니다.
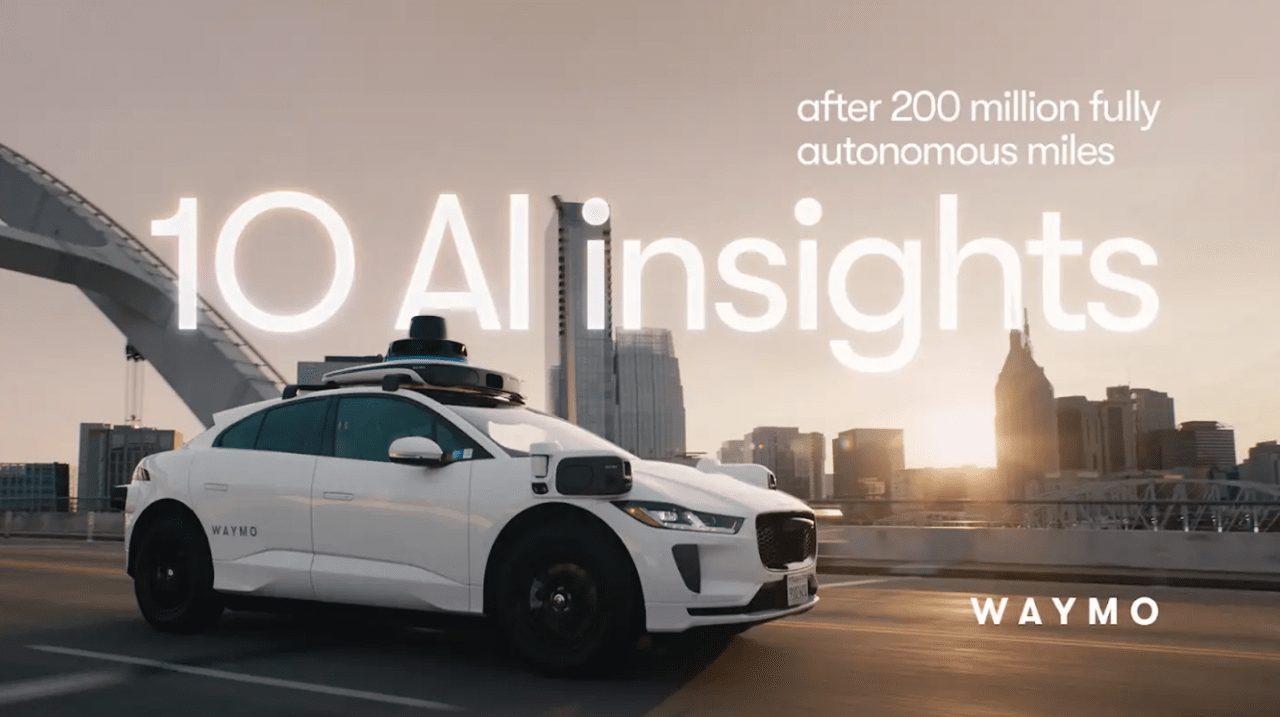
웨이모는 2억 마일이 넘는 실제 완전 무인 주행 데이터를 바탕으로, 카메라만으로 대규모 완전 자율주행의 안전성을 담보하기 어렵다고 밝혔습니다. 카메라는 색상과 표지판 같은 의미 정보를 제공하지만, 역광·악천후·어둠에서 성능이 약해질 수 있다는 설명입니다. 웨이모는 카메라, 라이다, 레이더를 결합해 서로의 약점을 보완하는 센서 융합 방식을 유지하고 있습니다. 이 사례는 모델 정확도와 별개로 입력 장치의 중복성이 안전 설계의 일부라는 점을 보여 줍니다.
KAIST 공동연구팀은 스마트폰에 부착하는 LED 장치와 AI 분석으로 숨겨진 카메라를 찾는 스윕LED를 개발했다고 밝혔습니다. 조명 방향을 바꿀 때 나타나는 반사 변화가 일반 광택 물체와 카메라 렌즈에서 다르다는 점을 이용합니다. 실제 환경의 30개 물체 평가에서 탐지 정확도 94%, 물체당 검사 시간 5초 이내를 기록했다고 기사에서 전했습니다. 센서 움직임으로 더 풍부한 신호를 만들고 AI가 시간 변화를 판별하는 방식입니다.
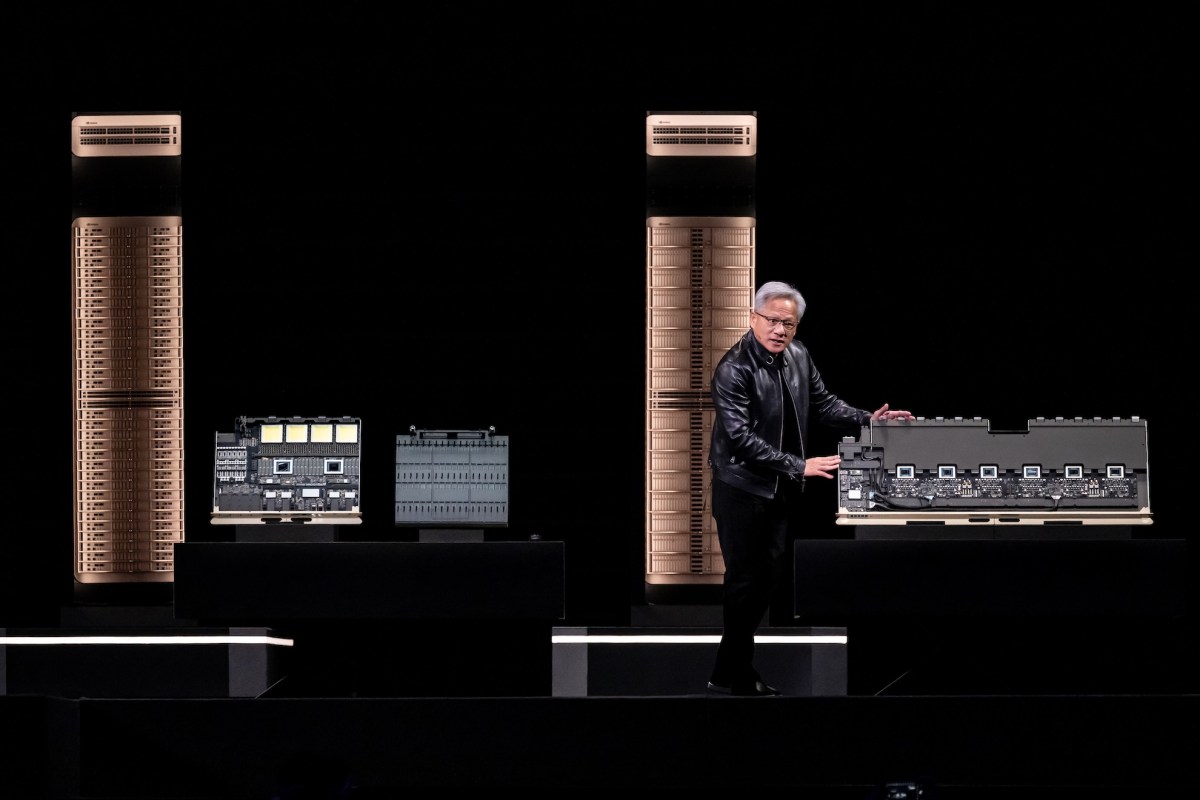
TechCrunch는 대형 AI 데이터센터에서 엔비디아의 강점이 GPU 자체를 넘어 주변 시스템으로 넓어지고 있다고 분석했습니다. Vera Rubin 구성은 GPU 외에 Vera CPU, 추론 가속기, 저장장치·네트워크 랙을 함께 묶습니다. 기사에 따르면 Vera CPU는 서버 메모리와 GPU 사이의 데이터 이동을 조율하는 역할에 초점을 둡니다. GPU 경쟁이 심해져도 대규모 운영의 병목을 해결하는 시스템 역량이 차별화 요인이 될 수 있다는 관점입니다.
TechCrunch는 캐터필러가 광산 자동화에서 얻은 경험을 AI 배포에 적용하려는 움직임을 다뤘습니다. 원문은 광산 현장의 자동화 경험을 AI 운영의 출발점으로 제시합니다. 이는 AI를 모델 도입만으로 보지 않고, 장기간 운영해 온 물리적 장비·작업 절차와 함께 설계한다는 접근입니다. 세부 사업 수치나 성과는 원문에서 추가로 확인되지 않아 포함하지 않았습니다.
TechCrunch는 소니 뮤직과 워너가 앤트로픽을 상대로 지식재산권 침해를 주장하는 소송을 제기했다고 보도했습니다. 기사 제목과 원문 메타데이터는 이 사안을 앤트로픽의 음악 관련 저작물 취득 문제로 다룹니다. 생성 AI의 성능 경쟁과 별개로 학습 데이터의 권리·출처가 사업 위험으로 남는다는 점이 핵심입니다. 소송의 최종 판단이나 책임 범위는 아직 확정된 사실로 다룰 수 없습니다.
TechCrunch는 AI 인프라 확대를 위한 가스 터빈 증설 경로가 오염 문제를 동반한다고 보도했습니다. 원문은 더 빠른 전력 확보와 환경 부담 사이의 긴장을 제목과 기사 맥락에서 제기합니다. 모델과 칩의 성능 향상은 전력 조달 문제를 자동으로 해결하지 않습니다. AI 인프라 계획은 전력원, 지역 환경 영향, 확장 속도를 함께 검토해야 합니다.
Simon Willison은 AI 에이전트가 디버그된 코드를 더 많이 만들 수 있다면 코드 줄 수가 생산성의 한 신호가 될 수 있다고 말합니다. 다만 품질, 유지보수성, 테스트가 같다는 조건이 전제입니다. 글의 핵심 제한은 코드 생성 속도가 아니라 사람이 그 규모의 코드를 이해하고 관리할 수 있는 인지 능력이라고 봅니다. 따라서 소수 인력으로 코드 생산량만 늘리는 판단은 팀의 검토·운영 역량을 함께 고려해야 합니다.
Qwen 3.8 27B의 기본 추론 설정을 설명하는 이미지. Simon Willison 원문.
Simon Willison은 27B 규모의 비전 가능 Qwen 3.8 모델을 소비자 장비에서도 유의미한 크기라고 평가했습니다. 다만 공식 기본값인 xhigh 추론 노력은 단순한 요청에도 과도한 사고 토큰을 쓰며, LM Studio의 8,192 토큰 문맥 한도에 빠르게 닿는 사례를 들었습니다. 문서에는 medium과 low 설정이 속도·비용 균형 또는 효율을 위한 선택지로 제시됩니다. 모델의 벤치마크 성능만큼 배포 시 기본 추론 예산을 조정하는 일이 중요하다는 실사용 관찰입니다.
LLM 0.32는 추론 모델의 추론 흔적 표시, 서버 측 도구, 내용 주소형 SQLite 로그를 추가했다고 Simon Willison이 소개했습니다. 표준 출력과 분리해 추론 흔적을 표준 오류로 보낼 수 있으며, 숨기는 옵션도 제공합니다. OpenAI의 코드 실행·웹 검색 도구와 Anthropic 플러그인의 웹 검색·가져오기·코드 실행·MCP 지원도 포함됩니다. 도구 호출을 쓰는 애플리케이션에서는 결과뿐 아니라 로그와 실행 경로를 남기는 기능이 운영에 중요해집니다.
이미지 검증 메모 선정한 원문 HTML에서 공식 이미지 URL을 확인해 4개 파일을 로컬에 저장했습니다. 논문 페이지에서 방법·결과를 설명하는 저자 그림을 신뢰성 있게 분리하지 못해 논문 이미지는 넣지 않았습니다. 빈 이미지 칸이나 대체 장식은 사용하지 않았습니다.