원제: Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills · arXiv
쉽게 말하면
연구 에이전트가 매번 긴 저장소를 처음부터 읽지 않도록, 실행에 필요한 요령을 작은 기술 묶음으로 만들었습니다. 같은 모델과 예산이라도 이 운영 지식이 있으면 벤치마크 수행 결과가 달라질 수 있다는 주장입니다.
논문은 무엇을 했나
저자들은 모델의 계획·실행·메모리·검증 바깥에 있는 실무 지식을 ‘운영 지식’으로 정의합니다. DisCo는 널리 쓰이는 저장소에서 범용 기술을, 주어진 과제에서 과제별 기술을 각각 만듭니다. 공개 생태계의 1,000개 저장소를 바탕으로 5,000개 이상의 검증 기술을 구성했다고 설명합니다. 고정된 GPT-5.5 백본과 실행 예산에서 기술 유무를 비교했습니다.
원제: HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness? · arXiv
쉽게 말하면
같은 AI 모델도 실행 절차와 도구 연결 방식에 따라 일의 결과가 달라집니다. 이 논문은 모델이 그 실행 틀까지 스스로 만들고 고칠 수 있는지를 시험했습니다.
논문은 무엇을 했나
HarnessDev는 결과물 대신 실행 가능한 인프라를 평가 단위로 옮깁니다. Creation에서는 최소한의 씨앗과 사례에서 하네스를 만들고, Evolution에서는 실행 피드백으로 이를 반복 수정합니다. 여섯 개 모델, 네 도메인, 다섯 벤치마크의 2,207개 고유 인스턴스를 사용했습니다. 성능 향상은 일부 있었지만, 사람의 성숙한 하네스와의 격차 및 다른 모델·미공개 과제로의 전이 한계도 보고합니다.
핵심 근거
목표모델의 하네스 생성·개선 능력 측정
방법생성 및 반복 개선, 성공률과 실행 토큰 비용 평가
결과글쓰기·ML 실험에서는 기준 하네스와 맞먹거나 넘기도 했으나 개선은 불안정
지표2,207개 인스턴스; 능력과 실행 토큰 비용을 함께 측정
Hugging Face Daily Papers · 2026-09-02 · Junchao Huang 외 N명
원제: SolarWM: Open Data and Scalable Training for Long-Horizon Video World Models · arXiv
쉽게 말하면
짧은 영상만 보고 끝나는 생성 모델을, 더 오래 상호작용하는 가상 세계로 확장하려는 기반 작업입니다. 서로 다른 영상 자료를 같은 형식으로 정리해 여러 모델이 비교 가능하도록 했습니다.
논문은 무엇을 했나
SolarWM은 데이터 준비부터 장기 추론까지의 공개 기반을 제안합니다. 10개 데이터셋의 143만 개 클립을 프레임 정렬된 공통 계약으로 변환했다고 밝힙니다. Wan2.2, LTX-2.5, MiniMax-H3에 기반한 5B~33B 모델 네 종을 공통 인터페이스에서 구성했습니다. 5초 시퀀스로 학습한 뒤 수분에서 수시간의 실시간 상호작용 롤아웃을 목표로 했습니다.
핵심 근거
목표재현 가능한 장기 상호작용형 영상 월드 모델 기반
방법다중 데이터 엔진과 3단계 적응·증류 학습
결과서로 다른 백본을 같은 학습·추론 인터페이스에서 구성
지표10개 데이터셋, 143만 클립, 5B~33B 네 모델
Hugging Face Daily Papers · 2026-09-02 · Yuling Shi 외 N명
텐센트와 NUS·PolyU 공동 연구진은 키보드 입력을 캐릭터·카메라 움직임이 반영된 영상으로 바꾸는 H3-월드를 공개했다고 AI타임스가 전했습니다. 기사는 이를 프롬프트 기반 영상 생성에서 사용자 조작에 반응하는 월드 모델로의 전환으로 설명합니다. SolarWM의 장기·상호작용형 영상 기반과 같은 방향에서 읽을 수 있습니다.
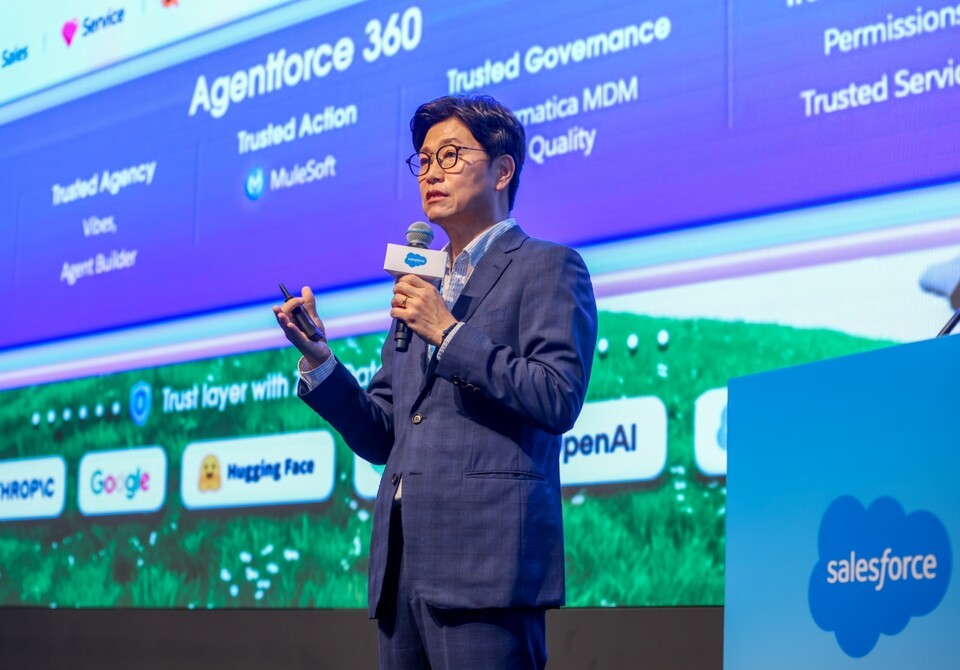
더에이아이는 세일즈포스가 상담 자동화와 사람의 판단을 함께 두는 에이전틱 컨택센터 구상을 제시했다고 보도했습니다. 업무 흐름 전체를 자동화하기보다 판단 지점을 남겨 두는 방식입니다. HarnessDev가 보여 준 것처럼 모델 외부의 실행 설계가 실제 성과에 중요하다는 맥락과 맞닿습니다.
TechCrunch는 AI 모델의 안전장치를 제거하는 서비스를 사업화하는 Abliteration.ai를 다뤘습니다. 안전 제약을 줄이는 행위가 별도 시장으로 형성되는 상황을 보여 줍니다. 보상 해킹 보도와 함께 보면, 모델 성능뿐 아니라 배포 후 통제 경로를 검증해야 한다는 과제가 더 선명해집니다.
TechCrunch는 Ollie가 개인정보 보호에 초점을 맞춰 AI 비서 시장에서 경쟁하려 한다고 보도했습니다. 이 접근은 모델의 기능 경쟁과 별개로, 데이터 경계를 제품 차별점으로 삼는 사례입니다. 에이전트 하네스를 설계할 때도 접근 권한과 기록 보존 방식을 함께 정해야 한다는 실무적 시사점이 있습니다.
Simon Willison은 앤트로픽이 Claude.ai와 모바일 앱의 시스템 프롬프트 및 변경 이력을 공개하는 방식을 짚었습니다. 문서 URL에 .md를 붙여 기계가 읽기 쉬운 형태로 받을 수 있다는 점도 소개합니다. 그는 최신 프롬프트가 노래 가사 재현을 강하게 제한한다고 관찰했습니다.
Simon Willison은 Claude Fable 5.1의 Terminal-Bench-Science 0.1 점수 52.6%라는 발표 수치를 소개했습니다. 같은 글에서 이전 Fable 5의 24.7%, Opus 5의 29.0%, GPT-5.6 Sol의 22.4%와 비교합니다. 다만 자신이 쓰던 펠리컨 예시는 모델 간 일반 성능을 대변하는 지표로 믿기 어려워졌다고 평가합니다.
The Gradient의 에세이는 합리적인 인간과 AI가 고정된 최종 목표를 가져야 한다는 전제를 비판합니다. 글은 인간 행동을 최종 목표가 아니라 덕과 상황 판단의 관점에서 다뤄야 한다고 주장합니다. 이는 보상 함수 하나로 통제를 해결하려는 접근의 한계를 사유하는 자료입니다.
RSS의 HN 후보는 Cerebras에서 Qwen 3.8 27B를 초당 1,500토큰으로 제공한다는 항목을 가리킵니다. 연결된 공식 문서는 모델 카탈로그 페이지로 확인했습니다. 페이지 본문에서 해당 성능 수치의 상세 조건을 확인하지 못했으므로 수치는 RSS 후보 정보로만 표기합니다.
선정한 원문 11개에 대해 공식 페이지 HTML을 직접 요청했습니다. 이 중 TechCrunch의 Astra URL은 404, OpenAI 안전성 URL은 403이어서 각각 제한 문구를 표시했습니다. 검증한 로컬 이미지 파일은 3개이며, 각 이미지에는 figure·대체텍스트·캡션·원문 링크를 넣었습니다.