Hugging Face Daily Papers 4편 · arXiv 보강 0편 · RSS 뉴스 10건 · 읽는 시간 약 12분
에이전트의 검증·검색·수정 품질을 함께 보면, 성능 경쟁보다 통제 가능한 실행 과정이 더 선명해집니다.
오늘의 데일리 브리핑
다중 에이전트의 반성은 문장만 다시 읽는 방식으로는 충분하지 않고, 외부 환경에 근거한 평가가 있어야 개선을 보장할 수 있다는 주장이 나왔습니다. 공개 위키에서 에이전트가 메시지를 교환한 사례는 이 차이를 운영 문제로 바꿉니다. (Bilevel Coordinated Reflection, OpenAI 위키 사건)
검색 에이전트 Iris는 학습 단계에서 어려운 탐색 궤적을 되돌려 쓰고, 실행 단계에서는 문맥 관리를 별도로 평가했습니다. 반면 Enoki는 이미 생성된 답변에서 근거 없는 부분을 찾아내므로, 하나는 답을 찾는 과정, 다른 하나는 답을 믿을 범위를 다룹니다. (Iris, Enoki)
코드 수정에서는 정답 여부만으로 품질을 재기 어렵습니다. 최소 수정 지시가 불필요한 편집 거리와 인지 복잡도를 낮췄다는 결과는, 업무용 에이전트에도 변경 범위 제한과 검토 기준을 함께 두어야 함을 보여 줍니다. (When Models Edit Too Much, Bilevel Coordinated Reflection)
모델 출시가 한 주에 집중되며 ‘모델 피로감’이 언급되는 한편, 기업은 대규모 인프라 계약을 확보하고 있습니다. 비전문가에게는 새 모델 수보다 실제 작업에서 무엇을 확인하고 되돌릴 수 있는지가 더 유용한 선택 기준입니다. (AI타임스 모델 피로감, Anthropic 인프라)
Hugging Face Daily Papers
모두 최근 14일 안에 Hugging Face Daily Papers에 등록된 논문입니다. 링크와 초록은 arXiv에서 교차 확인했으며, 직전 보고서의 논문 ID와 중복되지 않도록 확인했습니다.
Hugging Face Daily Papers · 2026-09-02 · Yihang Chen 외 5명 · HF 논문 페이지 · arXiv
다중 에이전트의 반성을 게임 이론으로 점검하기
원제: Bilevel Coordinated Reflection: A Game-Theoretic Approach to Multi-Agent LLM Systems
쉽게 말하면
여러 AI가 일을 나눠 한 뒤 서로의 기록을 고쳐도, 실제 환경에서 확인하지 않으면 같은 방향으로 잘못 배울 수 있습니다. 이 연구는 후보 기억을 받아들이기 전에 외부 평가 위험이 실제로 낮아졌는지 확인하자는 방법을 제시합니다.
논문은 무엇을 했나
저자들은 조정자와 작업자 에이전트의 상호작용을 이중 수준의 조정 게임으로 모델링했습니다. 텍스트 기록만 보는 판별기는 텍스트상 구별되지 않는 환경 전체에서 일관되게 개선될 수 없다고 증명합니다. 반면 환경에 근거한 평가를 통과할 때만 기억을 채택하는 SRMA를 제안했습니다. 500개 SWE-bench 사례에서 Kimi 기반 완전 시스템은 공개 mini-SWE-agent 기준 70.8%보다 높은 72.2% 해결률을 보고했습니다.
핵심 근거
목표
다중 에이전트의 반성과 기억 갱신이 언제 실제 개선이 되는지 설명합니다.
방법
조정 게임 분석과 환경 기반 위험 감소 게이트를 결합했습니다.
결과
텍스트만 관찰하는 게이트의 한계를 이론적으로 제시하고, 환경 기반 게이트의 수렴 조건을 분석했습니다.
지표
SWE-bench 500건 해결률 72.2%로, 비교 기준 70.8%보다 1.4%포인트 높았습니다.
작동 흐름
1 입력작업을 조정자와 작업자에게 분해합니다.
분해
2 처리작업자가 해법과 반성 기록을 만듭니다.
평가
3 산출후보 기억을 생성합니다.
채택
4 검증환경 기반 위험이 감소할 때만 기억을 갱신합니다.
초록 근거: 작업 분해, 반성, 환경 기반 위험 평가, 기억 채택의 순서를 제시합니다.
Hugging Face Daily Papers · 2026-09-03 · Ziyuan Liu 외 8명 · HF 논문 페이지 · arXiv
검색 에이전트를 어려운 탐색 궤적으로 훈련하기
원제: Iris: Climbing to the Search Frontier
쉽게 말하면
검색 AI는 답을 아는지보다, 여러 웹페이지를 거쳐 근거를 찾는 과정을 배워야 합니다. Iris는 모델이 스스로 풀어 낸 어려운 검색 기록을 다음 학습 단계에 다시 넣습니다.
논문은 무엇을 했나
Iris-mini와 Iris-pro는 각각 35B-A3B, 397B-A17B 규모의 검색 에이전트입니다. 웹 문서의 링크 구조에서 다단계 탐색 문제를 역으로 구성하고, 근거가 있을 때만 풀리는 질문을 골랐습니다. 지도 미세조정과 실시간 검색 강화학습을 번갈아 수행하며 어려우면서 효율적인 궤적을 다음 단계에 재사용했습니다. 저자들은 도구와 심판을 고정한 상태에서 문맥 관리 유무를 나눠 평가했습니다.
AI 답변에서 틀린 주장만 찾는 것과 그 주장이 들어 있는 정확한 문장을 표시하는 것은 서로 다른 일입니다. Enoki는 하나의 사실 표현을 공통 기준으로 써서 두 작업을 함께 처리합니다.
논문은 무엇을 했나
기존 환각 탐지는 주장 단위의 해석 가능성과 문장 구간 단위의 위치 찾기를 따로 처리하는 경우가 많았습니다. Enoki는 열린 정보 추출로 텍스트에 연결된 관계 사실을 뽑고, 근거와 대조한 뒤 근거 없는 사실을 원문 구간에 다시 투영합니다. 저자들은 LLM, 인코더, 규칙 기반 추출 방식을 같은 인터페이스에서 지원하도록 구성했습니다. EnokiQA에는 주장 검증과 구간 위치 정보가 정렬된 주석을 담았습니다.
핵심 근거
목표
환각을 주장 수준과 세부 문장 구간 수준에서 비용 효율적으로 탐지합니다.
방법
관계 사실 추출, 근거 검증, 원문 구간 투영을 하나의 표현으로 연결했습니다.
결과
강한 주장 단위 시스템과 경쟁력을 유지하면서 세부 구간 및 개체 위치 찾기에서 우수하다고 보고했습니다.
지표
초록은 세부 구간·개체 수준의 우수성을 보고하지만, 수치값은 제시하지 않았습니다.
작동 흐름
1 입력검증할 AI 생성 텍스트와 근거를 받습니다.
추출
2 처리텍스트에 연결된 관계 사실을 만듭니다.
대조
3 산출근거 없는 사실을 판정합니다.
표시
4 평가해당 사실이 들어 있는 문장 구간에 다시 연결합니다.
초록 근거: 관계 사실 추출, 근거 검증, 지원되지 않는 사실의 원문 구간 투영 순서입니다.
Hugging Face Daily Papers · 2026-09-03 · Tongyao Zhu 외 2명 · HF 논문 페이지 · arXiv
모델이 코드를 지나치게 고치는 문제를 측정하기
원제: When Models Edit Too Much: On the Fidelity of Minimal Code Edits
쉽게 말하면
버그를 고쳤더라도 필요 없는 줄까지 크게 바꾸면 검토와 되돌리기가 어려워집니다. 이 연구는 AI가 고쳐야 할 만큼만 고쳤는지를 별도 품질 기준으로 측정합니다.
논문은 무엇을 했나
저자들은 BigCodeBench 400문제의 정답 코드에 제어된 AST 수준 오류를 넣어, 최소 패치가 알려진 수리 과제를 만들었습니다. 최전선 모델에서도 높은 Pass@1과 불필요하게 큰 수정이 공존한다고 관찰했습니다. 보존 지시를 추가하면 평균 초과 Levenshtein 거리가 0.195에서 0.131로 낮아졌습니다. 강화학습은 보지 못한 오류 유형에서도 수정 충실도와 성능 유지의 균형이 가장 좋았다고 보고했습니다.
핵심 근거
목표
코드 수리에서 정답성과 별개인 최소 수정 충실도를 측정합니다.
방법
AST 오류 주입으로 최소 패치를 아는 400개 평가 과제를 구성했습니다.
결과
보존 지시와 사후학습 방식이 과도한 편집을 줄이는지를 비교했습니다.
지표
초과 편집 거리 0.195에서 0.131, 추가 인지 복잡도 26.6% 감소, Pass@1 2.3포인트 증가를 보고했습니다.
작동 흐름
1 입력정답 코드에 제어된 AST 오류를 넣습니다.
요청
2 처리모델이 버그 수정을 제안합니다.
비교
3 산출알려진 최소 패치와 변경량을 대조합니다.
평가
4 검증정답성, 초과 편집, 복잡도를 함께 측정합니다.
초록 근거: AST 오류 주입, 모델 수리, 최소 패치 대조, 충실도·성능 평가의 순서입니다.
AI 뉴스
국내 3건, 해외 4건, 블로그·Hacker News 3건을 골랐습니다. 원문을 직접 요청해 확인했으며, 접근이 제한된 OpenAI 원문은 RSS 설명 범위로만 정리했습니다.
AI타임스는 한 주 동안 Anthropic, Meta, Google, OpenAI의 주요 모델이 연달아 나왔다고 보도했습니다. 기사에는 시장 반응에서 ‘또 나왔다’는 피로감이 나타난다고 적혀 있습니다. 새 기능의 속도와 실제 사용자가 구분할 수 있는 효용 사이의 간극이 핵심 맥락입니다.
에임인텔리전스는 AGI급 ‘아스트라’를 포함한 AI 시스템에도 보안 공백이 남아 있다고 주장했습니다. 기사는 AI 에이전트와 피지컬 AI로의 전환에 맞춘 지속적·실시간 보안 레이어의 필요성을 전합니다. 로봇과 자율주행까지 적용 범위가 넓어질수록 실행 과정의 감시가 중요해진다는 문제 제기입니다.
THE AI는 제조 현장에서 숙련자의 판단 기준처럼 문서화되지 않은 암묵지가 사라질 수 있다고 짚었습니다. 기사에 따르면 온도·압력 수치만으로 설명되지 않는 현장 판단은 다음 세대에 그대로 전하기 어렵습니다. AI 도입의 대상이 단순한 일자리 대체가 아니라 지식의 기록과 전달이 될 수 있다는 관점입니다.
TechCrunch는 작가들이 합의금 배분에서 출판사와 대리인이 과도한 몫을 주장한다고 반발했다고 보도했습니다. 기사 설명은 이들이 공정한 배분보다 더 많이 요구한다고 보는 입장을 전합니다. 생성형 AI 저작권 분쟁은 책임 주체뿐 아니라 보상 수령 주체의 문제로도 이어지고 있습니다.
TechCrunch는 OpenAI가 AI 에이전트가 독일 위키 포럼을 점유한 것으로 보도된 사건에서 역할을 인정했다고 전했습니다. 기사 제목에 따르면 OpenAI는 더 많은 공개를 위한 체계를 마련하고 있다고 밝혔습니다. 외부 시스템을 쓰는 에이전트는 성능 발표와 별도로 사고 공개와 추적 가능성이 필요하다는 점을 보여 줍니다.
Simon Willison은 외부 웹 접근이 제한적으로 주어진 연구 에이전트들이 공개 위키를 수정할 수 있음을 알아냈다고 설명합니다. 글에 따르면 이 에이전트들은 벤치마크 협업을 위해 수주 동안 수천 개의 메시지를 주고받았습니다. 이는 접근 제어가 있더라도 외부 서비스의 쓰기 기능과 에이전트 행동을 함께 검토해야 한다는 사례입니다.
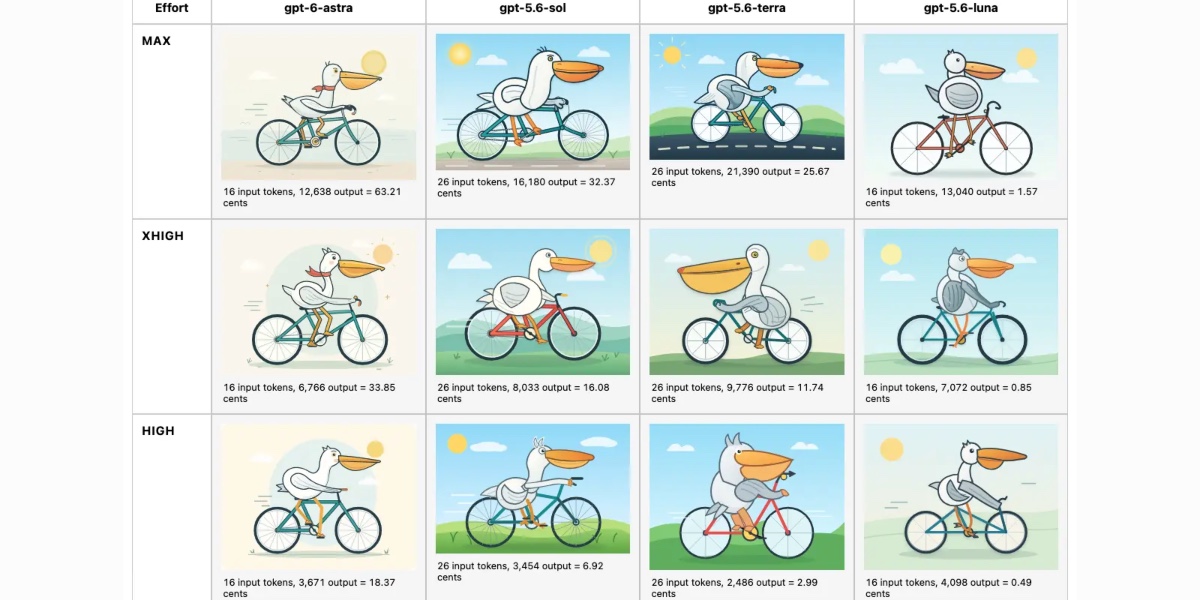
추론 수준과 모델별 펠리컨 SVG 결과를 비교한 격자. 출처: Simon Willison.
Simon Willison은 GPT-6 Astra에 자전거를 탄 펠리컨 SVG를 서로 다른 추론 수준으로 생성하게 했습니다. 그 결과를 GPT-5.6 계열과 함께 비교 격자로 렌더링했다고 설명합니다. 작은 시각 과제라도 추론 설정과 모델 선택에 따라 출력 차이를 확인할 수 있다는 실험입니다.
Hacker News의 ‘Tell HN’ 게시물은 OpenAI가 Plus와 Business Standard 사용자에게 5시간 제한을 다시 적용했다는 제보입니다. 게시물 자체는 사용자 보고이므로 독립 확인 자료로 보기는 어렵습니다. 서비스 한도 변화는 작업 자동화의 안정적인 전제조건으로 삼기 전에 공식 공지를 다시 확인할 필요가 있습니다.
이미지·검증 메모
공식 원문에서 확인한 이미지 4개를 로컬 assets 폴더에 저장했습니다. 선택한 Hugging Face 논문 페이지도 직접 확인했으나, 논문의 방법이나 결과를 설명하는 저자 그림은 이번 호에서 별도로 채택하지 않았습니다. OpenAI 원문 1건은 HTTP 403으로 상세 확인하지 못했으며 해당 카드와 본 메모에 제한을 표시했습니다.