2026년 9월 9일 · 약 12분 읽기 · HF 논문 4편 · arXiv 보강 0편 · RSS 뉴스 10건
AI 기술 데일리 리서치
생성 속도, 검증 가능한 에이전트, 그리고 기업 도입의 운영 조건을 함께 읽습니다.
오늘의 데일리 브리핑
생성 모델의 경쟁은 단순 성능보다 같은 품질을 더 빨리 내는 방식으로 이동합니다. Uno는 자동회귀 모델의 품질을 유지하면서 최대 3배 속도를 제시했고, Mercury 2.5도 빠른 생성 모델을 내세웠습니다.
에이전트는 답을 만들기보다 검증 가능한 실행이 중요해집니다. FlowBalance는 결과 검증기로 자기개선을 조절하고, EmbodiedSkills는 로봇 행동 전후를 확인하는 폐루프를 제안합니다.
국내에서는 삼성전자·미스트랄의 반도체 특화 AI 협력이 눈에 띕니다. 현장 도입에서는 모델 자체보다 데이터·업무 연결과 책임 있는 운영이 성패를 가를 가능성이 큽니다.
개인 도구도 일하는 방식에 맞춰 재편됩니다. ChatGPT Work와 Meta Muse 관련 소식은 기능 확장보다 계정 보안과 사용자의 신뢰가 선행되어야 한다는 점을 함께 보여 줍니다.
Hugging Face Daily Papers
손실 없이 LLM 생성 속도를 높이는 이산 확산
Unlocking Lossless Speedups in LLMs via Discrete Diffusion
Hugging Face Daily Papers · Subham Sekhar Sahoo 외 16명 · 2026-09-08 · HF 페이지 · arXiv
쉽게 말하면
문장을 한 토큰씩만 쓰던 언어 모델에 여러 토큰을 함께 제안하는 경로를 붙였습니다. 별도 초안 모델 없이도 원래 모델의 결과 품질을 유지하며 답변 속도를 높이려는 방법입니다.
논문은 무엇을 했나
연구진은 자동회귀 모델과 확산 가중치를 분리해, 기존 다음 토큰 예측 학습을 유지하면서 여러 토큰을 병렬로 뽑도록 했습니다. 새 확산 가중치는 별도 증류 단계로 학습합니다. Ψ-Spec 샘플러는 고정된 문맥 길이에서 손실 없는 가속을 목표로 합니다. 초록은 에이전트 도구 사용, 코딩, 긴 문맥 추론에서 비교 실험을 제시합니다.
핵심 근거
목표
자동회귀 생성의 순차 처리 병목을 줄입니다.
방법
경량 확산 가중치와 Ψ-Spec 샘플러를 결합합니다.
결과
평가한 모든 배치 크기에서 주요 speculative decoding 방법보다 높은 처리량을 보고했습니다.
지표
기본 자동회귀 모델 대비 최대 3배 속도 향상입니다.
작동 흐름
1. 입력 문맥과 다음 토큰 분포
병렬 제안 →
2. 처리 확산 가중치가 여러 토큰 생성
정렬 →
3. 산출물 자동회귀 분포에 맞는 응답
측정 →
4. 평가 처리량·벤치마크 비교
초록 근거: 자동회귀 분포를 유지하면서 확산으로 다수 토큰을 생성하고, Ψ-Spec으로 가속을 측정합니다.
검증기에 근거한 자기개선의 균형
FlowBalance: Verifier-Grounded Self-Improvement from On-Policy Reasoning Experience
Hugging Face Daily Papers · Zixun Huang 외 3명 · 2026-09-08 · HF 페이지 · arXiv
쉽게 말하면
모델이 자기 답변으로 학습할 때, 그럴듯하지만 틀린 답을 더 믿는 문제를 줄이려는 연구입니다. 외부 검증 결과가 좋은 답변은 강화하고 나쁜 답변의 자기 확신은 뒤집거나 끕니다.
논문은 무엇을 했나
FlowBalance는 완성된 답변 전체의 분포를 학습 대상으로 삼습니다. 같은 정책의 훈련용 관점이 토큰별 개선 신호를 만들고, 종료 검증기의 그룹 이점으로 그 신호를 조절합니다. 선호가 없는 롤아웃 그룹에서는 자기 안내를 사용하지 않습니다. 수학 추론 실험에서 FlowRL보다 평균 성능, 학습 속도와 안정성이 개선됐다고 설명합니다.
핵심 근거
목표
희소한 검증 신호와 과도한 자기확신을 함께 다룹니다.
방법
검증기 기반 이점으로 자기 안내 점수를 보정합니다.
결과
Qwen3-4B·8B 수학 추론에서 FlowRL 대비 평균 성능 개선을 보고했습니다.
지표
초록은 수치 대신 안정성·정답 전략 다양성 향상을 제시합니다.
새 데이터셋에도 적용하는 인과 추론 기반 모델
Causal Foundation Models
Hugging Face Daily Papers · Christopher Stith 외 2명 · 2026-09-08 · HF 페이지 · arXiv
쉽게 말하면
어떤 조치가 결과에 미친 영향을 데이터에서 추정하는 작업을, 매번 새 모델을 만들지 않고 풀려는 방향입니다. 사전학습 모델이 새 데이터셋에서 추가 학습 없이 인과 효과를 추정하는 가능성을 정리합니다.
논문은 무엇을 했나
논문은 인과 추론의 기존 절차인 메커니즘 가정, 추정기 선택, 학습 과정을 설명합니다. 이어 사전학습 모델의 맥락 내 학습을 인과 추론에 적용하는 CFM 개념을 소개합니다. CFM은 모델 가중치를 갱신하지 않고 새 데이터셋에서 평균 처치 효과 같은 값을 추정합니다. 예제 코드와 노트북을 함께 제공합니다.
핵심 근거
목표
문제마다 따로 만드는 인과 추론 파이프라인을 줄입니다.
방법
사전학습 모델이 맥락 내 학습으로 인과량을 추정합니다.
결과
실증 성능 주장보다 개념과 실무 배경을 제공하는 소개 논문입니다.
지표
초록에 비교 수치가 제시되지 않았습니다.
로봇 에이전트의 행동을 전후로 확인하는 통합 프레임워크
EmbodiedSkills: A Unified Framework for Orchestrating, Training, and Deploying VLA Agents
Hugging Face Daily Papers · Wei Wang 외 16명 · 2026-09-08 · HF 페이지 · arXiv
쉽게 말하면
로봇이 행동을 고르는 것만으로는 일이 끝나지 않습니다. 이 연구는 실행 전 조건을 검사하고 실행 뒤 결과를 확인해, 실패하면 회복 단계로 넘어가게 합니다.
논문은 무엇을 했나
EmbodiedSkills는 상위 기술 선택, 제한된 저수준 VLA 실행, 사후 검증을 하나의 반복 구조로 연결합니다. 공통 기술 인터페이스를 고정해 저수준 정책을 바꾸더라도 에이전트 반복 구조를 유지합니다. 구조화된 실행 기록은 각 구성 요소의 학습 자료가 됩니다. 연구진은 Qwen3-VL과 OpenPI/pi0.5를 RoboTwin 2.0 및 LIBERO에서 실험했습니다.
핵심 근거
목표
물리 환경에서 장기 작업을 폐루프로 수행합니다.
방법
사전 조건 검사, 실행, 결과 검증, 회복을 묶습니다.
결과
50개 RoboTwin 과제 평균 성공률 86.20%, 4개 LIBERO 묶음 97.40%를 보고했습니다.
AI타임스는 삼성전자와 미스트랄 AI가 반도체 특화 AI 개발에 나선다고 보도했습니다. 핵심은 범용 모델을 그대로 쓰기보다 반도체 업무에 맞는 데이터와 지식을 결합하려는 움직임입니다. 현장 효과는 모델 공개보다 실제 설계·검증 흐름에 얼마나 들어가는지로 판단해야 합니다.
오픈AI 내부의 ‘AI 연구 인턴’ 신호
뉴스AI타임스 · 2026-09-08
AI타임스의 브리핑은 오픈AI 내부에서 AI가 연구 보조 역할을 수행하는 흐름을 다룹니다. 연구 자동화는 반복 실험과 문서 작업을 줄일 수 있습니다. 다만 연구 결과의 검증 책임과 재현 절차는 사람의 역할로 남습니다.
“연결하고 맡기고 남겨라”: 기업 AI 운영의 조건
뉴스THE AI · 2026-09-08
THE AI는 김경훈 오픈AI코리아 대표의 기업 AI 활용 메시지를 전했습니다. 업무 맥락을 연결하고 작업을 위임하며 기록을 남기는 흐름이 핵심으로 제시됩니다. 이는 EmbodiedSkills의 실행·검증 기록과도 닮아 있습니다.
ChatGPT Images 2.5 공개
뉴스OpenAI · 2026-09-08
RSS는 OpenAI가 ChatGPT Images 2.5를 소개했다고 알립니다. 이번 실행에서는 원문 서버가 403 응답을 반환해 세부 기능과 수치를 확인하지 못했습니다. 원문 상세 확인 불가
GPT-5.6 Sol의 양자 컴퓨팅 실험 지원
아티클OpenAI · 2026-09-08
RSS는 GPT-5.6 Sol이 양자 컴퓨팅 실험을 지원한 사례를 제목 수준에서 제시합니다. 원문 서버가 403 응답을 반환해 적용 범위와 결과를 확인하지 못했습니다. 원문 상세 확인 불가
Meta의 개인 AI 에이전트 Muse
뉴스Meta AI · 2026-09-08
Meta는 Muse를 개인 AI 에이전트로 소개합니다. 개인 맥락을 다루는 에이전트일수록 기능보다 사용자가 통제 범위와 데이터 처리를 이해할 수 있어야 합니다. 서비스의 실제 신뢰도는 이 설명과 운영 경험에 달려 있습니다.
Claude 구독자 토큰 탈취 보도
뉴스TechCrunch · 2026-09-08
TechCrunch는 공격자가 Claude 구독자의 토큰을 탈취하는 사례를 보도했습니다. AI 도구를 업무에 연결할수록 계정 토큰은 모델 성능 못지않은 보안 경계가 됩니다. 조직은 공유 계정과 비공식 확장 프로그램의 사용 범위를 점검할 필요가 있습니다.
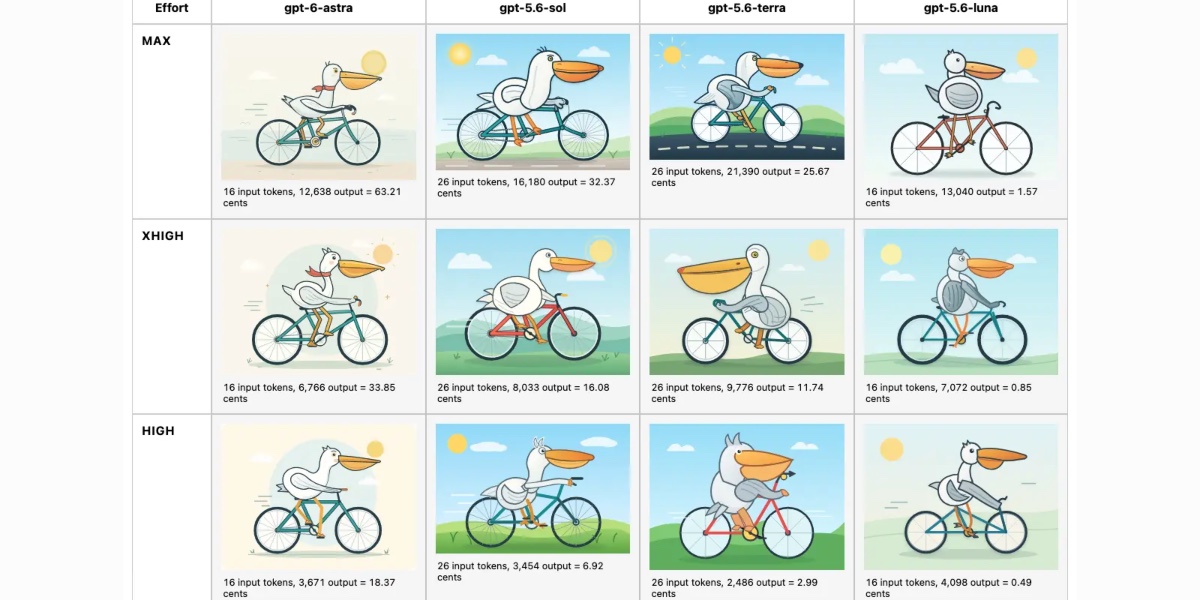
Simon Willison은 Astra의 여러 추론 수준으로 자전거를 탄 펠리컨 SVG를 생성해 비교했습니다. 같은 지시문에서도 추론 예산이 결과의 정교함에 영향을 줄 수 있음을 보여 주는 관찰입니다. 다만 단일 창작 과제이므로 일반 성능 비교로 확대 해석해서는 안 됩니다.
ChatGPT Work의 사용 맥락
아티클Simon Willison · 2026-08-31
Simon Willison은 ChatGPT Work를 강력하지만 이해하기 복잡한 제품으로 평가합니다. 업무 도구는 기능 목록보다 권한, 자료 연결, 결과물의 소유와 검토 흐름이 더 중요합니다. 조직 도입 시에는 작은 업무 단위에서 검증 기록을 남기는 편이 안전합니다.
Inception은 Mercury 2.5를 소개했습니다. 빠른 생성 모델의 등장은 Uno 논문이 다룬 병렬 생성 경쟁과 같은 방향을 가리킵니다. 실제 선택에서는 속도뿐 아니라 품질, 비용, 배포 환경을 함께 비교해야 합니다.
검증 기록: RSS 후보 10건을 선택했고, 원문 확인 실패는 OpenAI 2건입니다. Hugging Face Daily Papers 4편은 최근 14일 내 게시 목록에서 골랐으며 이전 보고서의 HF 링크와 중복되지 않았습니다. 공식 출처에서 내려받은 이미지 파일은 3개이며, 모든 이미지 경로는 이 HTML과 같은 폴더 기준의 로컬 파일입니다.