2026년 9월 15일 · 약 17분 읽기 · HF 논문 4편 · arXiv 보강 0편 · RSS 10건
AI 기술 데일리 리서치
로봇의 실행력, 업무 에이전트의 비용, 그리고 배포 통제가 함께 중요해진 하루입니다.
오늘의 데일리 브리핑
논문은 로봇의 언어 이해를 실제 제어와 미래 장면 예측으로 연결합니다. 국내 조사에서 피지컬 AI를 전면 도입한 기업은 6%에 그친 만큼, 실험 성과를 현장 운영으로 옮기는 단계가 핵심입니다. (MobileVLA-R1 2.0, Pelican-Sim 1.0, AWS 한국 조사)
코딩 모델 SWE-2와 Occamy-1.0은 최고 점수만 높이기보다 비용과 추론 강도를 함께 조정합니다. 실제 업무 도입에서는 모델 선택보다 작업별 비용 한도와 평가 기준을 먼저 정해야 합니다. (SWE-2, Occamy-1.0)
자율 에이전트의 범위가 넓어질수록 권한 통제와 사후 관찰이 중요해집니다. AWS의 OAuth 동의 관리, RubyGems 사례, Pion의 실제 사업 실험은 각각 권한·외부 영향·장기 실행이라는 다른 위험 지점을 보여줍니다.
비전문가에게 가장 실용적인 기준은 결과의 그럴듯함이 아니라 재현 가능한 실행 기록입니다. 모델이 무엇을 했고 어떤 권한으로 실행했는지 확인할 수 있어야 승인과 책임을 나눌 수 있습니다.
Hugging Face Daily Papers
Hugging Face Daily Papers · 2026-09-08 · Yiran Wang 외 3명 · HF 원문 · arXiv
검색한 동작을 생성 모델이 바로 쓰게 하는 사람 움직임 생성 ReMoMask-2: Latent Retrieval-Augmented Masked Motion Generation
쉽게 말하면
문장으로 설명한 동작과 비슷한 예시를 먼저 찾아 사람 관절 움직임을 더 자연스럽게 만드는 연구입니다. 찾아온 예시를 생성 모델의 내부 표현에 맞춰 두므로, 복잡한 지시도 한 단계에서 처리합니다.
논문은 무엇을 했나
텍스트-투-모션은 자연어를 사람 관절 움직임으로 바꾸는 기술입니다. 저자들은 검색 결과와 생성 모델의 내부 표현이 분리되어 있다는 문제를 짚습니다. ReMoMask-2는 검색 데이터베이스를 생성기 잠재 공간에 다시 구축하고, 가벼운 투영기로 텍스트 질의를 맞춥니다. HumanML3D, KIT-ML, SnapMoGen에서 검색 정확도와 생성 품질을 비교했습니다.
핵심 근거
목표
복잡한 동작 설명에서 검색 결과를 생성에 더 잘 연결합니다.
방법
계층적 대조학습, 시공간 주의, 구조화 마스킹과 잠재 공간 검색을 결합합니다.
결과
단일 마스크-트랜스포머 단계가 기존 2단계 방식보다 빠르고 더 좋은 결과를 냈다고 보고합니다.
지표
KIT-ML·SnapMoGen에서 FID가 가장 낮았습니다. FID는 생성 동작 분포가 실제 데이터에 얼마나 가까운지를 보는 지표입니다.
Hugging Face Daily Papers · 2026-09-05 · Ting Huang 외 4명 · HF 원문 · arXiv
추론을 행동 제어에 연결하는 이동 로봇 모델 MobileVLA-R1 2.0: RL-Enhanced Reasoning for Mobile Robot Control
쉽게 말하면
로봇이 언어 지시를 들었을 때 생각 단계와 실제 모터 명령 사이의 간격을 줄이는 방법입니다. 고수준 계획은 공통으로 만들고 각 로봇의 제어기가 그 계획을 자기 몸에 맞는 명령으로 바꿉니다.
논문은 무엇을 했나
시각·언어·행동 모델은 언어 지시를 로봇 행동으로 옮기지만, 긴 작업에서 일관된 판단과 정밀 제어를 함께 유지하기 어렵습니다. MobileVLA-R1 2.0은 지도학습된 사고 과정과 강화학습으로 궤적 수준의 추론을 학습합니다. 이어 추론 조건부 행동 디코더가 작업 수준의 목표를 만들고 제어기가 장치별 명령으로 번역합니다. 저자들은 실내 길찾기, 사족보행, 휴머노이드 조작과 Unitree Go2·G1 실기기에서 평가했습니다.
핵심 근거
목표
언어 이해와 이동·조작 제어가 어긋나는 문제를 줄입니다.
방법
사고 과정 정렬, 강화학습, 추론 조건부 행동 디코더를 사용합니다.
결과
강한 VLA 기준 모델보다 일관되게 높은 성능을 보고했습니다.
지표
VLN-CE 성공률은 평균 1.6포인트, 실제 G1 전체 작업 성공률은 이전 모델보다 10.0포인트 높았습니다.
작동 흐름
1. 입력언어 지시와 시각 정보
해석 →
2. 처리추론 궤적 수준 계획
변환 →
3. 산출장치별 제어 명령
검증 →
4. 평가시뮬레이션·실기기 성공률
초록 근거: 지시·시각 입력을 추론과 행동 목표로 연결한 뒤 장치별 제어 명령으로 옮겨 평가하는 순서입니다.
Hugging Face Daily Papers · 2026-09-04 · Wenhui Chen 외 43명 · HF 원문 · arXiv
업무 에이전트의 비용·성능 균형을 겨냥한 35B 모델 Occamy-1.0: Open Pareto-frontier 35B Intelligence for Co-work
쉽게 말하면
업무 보조 모델이 같은 일을 더 싸고 빠르게 하도록 여러 능력을 함께 조정한 연구입니다. 가장 비싼 모델 하나를 고르는 대신, 작업의 난이도와 비용을 같이 보는 접근입니다.
논문은 무엇을 했나
업무 에이전트는 추론, 도구 사용, 긴 문맥 처리처럼 서로 다른 능력을 동시에 요구합니다. Occamy-1.0은 35B 규모 모델에서 이런 능력과 비용의 균형을 목표로 공개된 성능 경계를 제시합니다. 저자들은 여러 업무형 평가와 모델 비교를 통해 모델의 위치를 점검했습니다. 따라서 실제 사용 시에는 단일 벤치마크 점수보다 작업당 비용과 지연을 함께 확인해야 합니다.
핵심 근거
목표
협업 작업에서 비용과 지능 사이의 균형점을 넓힙니다.
방법
35B 모델을 업무형 추론·도구 사용 과제에서 비교합니다.
결과
저자들은 공개 모델의 비용·성능 경계에서 경쟁력 있는 위치를 보고합니다.
지표
여러 작업 평가와 비용·성능 경계가 핵심입니다. 경계는 같은 비용에서 더 좋은 성능, 또는 같은 성능에서 더 낮은 비용을 뜻합니다.
Hugging Face Daily Papers · 2026-09-10 · Shilong Zou 외 10명 · HF 원문 · arXiv
로봇 행동 뒤의 장면을 예측하는 범용 세계 모델 시뮬레이터 Pelican-Sim 1.0: A General World Model Simulator for Embodied Intelligence
쉽게 말하면
로봇이 행동하기 전에 다음 장면이 어떻게 바뀔지 가상으로 예측하게 하는 연구입니다. 실제 장비에서 무작정 시행착오를 하기 전에, 가능한 결과를 미리 비교하는 데 쓰려는 모델입니다.
논문은 무엇을 했나
물리 환경에서 작동하는 AI는 행동의 결과를 예측해야 안전하게 계획할 수 있습니다. Pelican-Sim 1.0은 시각 입력과 행동을 받아 이후 장면을 시뮬레이션하는 범용 세계 모델을 제안합니다. 저자들은 로봇 조작과 관련된 다양한 과제로 예측과 정책 학습 활용을 평가합니다. 다만 세계 모델의 영상이 실제 물리 현장을 완전히 대체한다는 뜻은 아니므로 실기기 검증이 계속 필요합니다.
핵심 근거
목표
행동 전 결과 예측을 통해 로봇 학습과 계획을 돕습니다.
방법
시각 관찰과 행동을 조건으로 미래 장면을 생성하는 세계 모델을 사용합니다.
결과
저자들은 시뮬레이션을 활용한 정책 학습 성과를 보고합니다.
지표
로봇 과제의 정책 성과를 비교합니다. 이는 예측된 환경에서 배운 행동이 과제를 얼마나 성공적으로 수행하는지 보는 값입니다.
작동 흐름
1. 입력현재 관찰과 후보 행동
조건화 →
2. 처리미래 장면 예측
구성 →
3. 산출가상 궤적
평가 →
4. 다음 조치정책 선택·검증
초록 근거: 관찰과 행동을 받아 미래 장면을 예측하고, 그 시뮬레이션으로 정책을 평가하는 순서입니다.
RSS 뉴스와 아티클
뉴스 AI타임스 · 2026-09-15
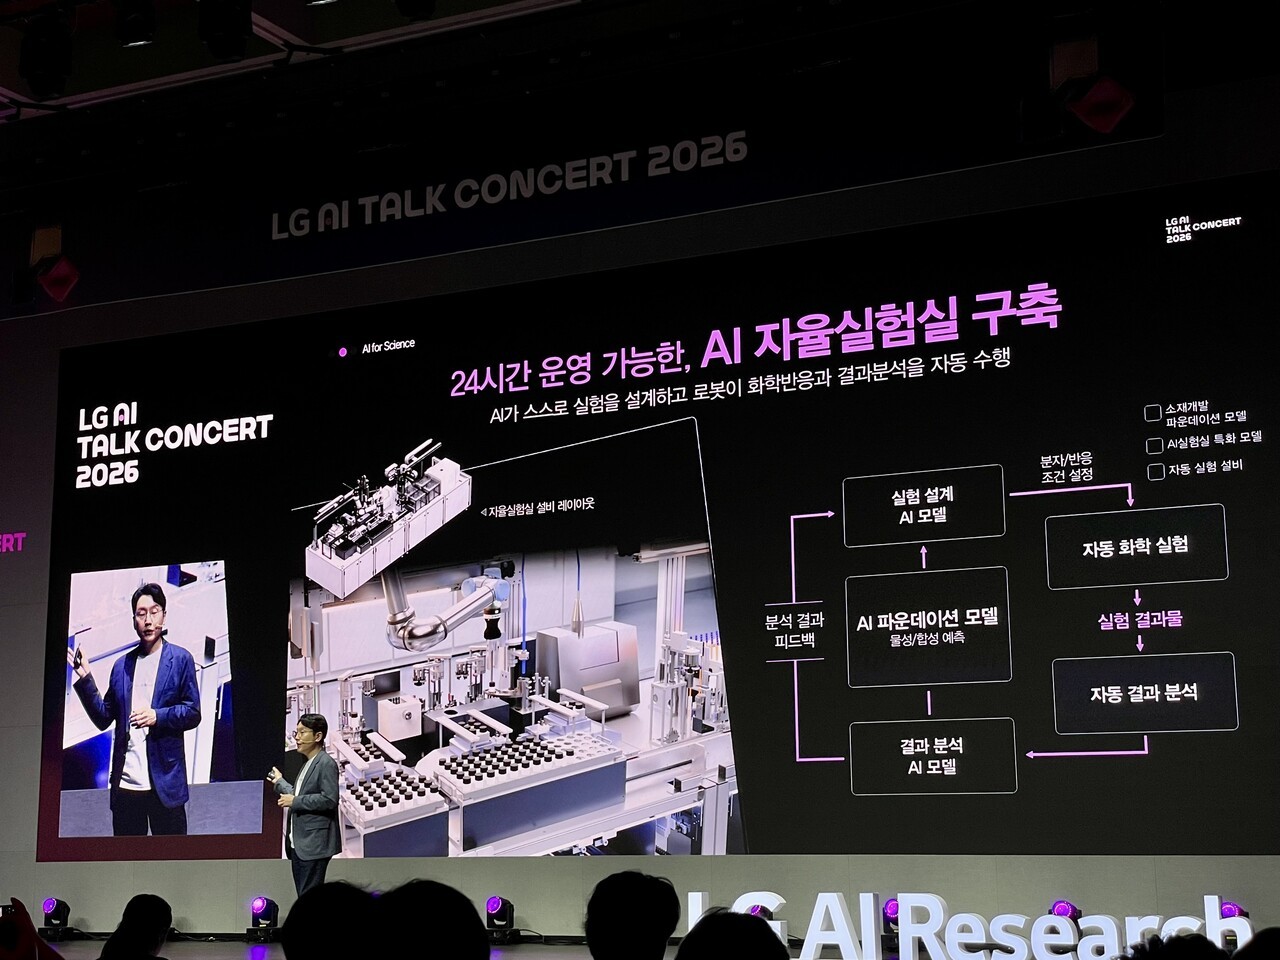
LG, 제조·과학·비즈니스 분야 전문가 AI 시리즈를 공개
LG AI연구원은 제조·과학·비즈니스 분야의 전문가 AI를 공개했습니다. 기사에 따르면 엑사원 옴니 인스펙트는 재학습 대응 시간을 최대 50시간으로 줄였고, 기존 14일 이상과 비교해 리드타임을 약 85% 단축했다고 설명합니다. 암 진단·치료 설계와 소재 개발 사례도 함께 제시됐지만, 현장 성과는 각 적용 조건에서 별도로 검증할 필요가 있습니다.
코그니션은 Kimi K3를 사후학습한 코딩 모델 SWE-2를 공개했습니다. 기사 기준 FrontierCode 1.1 Main에서 50.0%를 기록했으며, Fable 5.1과 0.9포인트 차이이면서 추론 비용은 64% 낮다고 밝혔습니다. 다만 Terminal-Bench 4에서는 비교 모델보다 낮아, 모든 코딩 작업에 같은 결과를 일반화하기는 어렵습니다.
AWS와 스트랜드 파트너스 조사에서 국내 기업의 AI 활용률은 58%로, 1년 전보다 10포인트 높았습니다. AI 도입 기업의 81%는 생산성 개선을, 평균 주당 14시간 절약을 답했습니다. 반면 공식적이고 포괄적인 AI 전략 보유 비율은 27%, 신뢰할 만한 ROI 측정 방법이 없다는 응답은 47%여서 확산과 운영 역량 사이의 간격이 보입니다.
아티클 Google DeepMind
Gemini의 에이전틱 비디오 이해 기능 소개
Google DeepMind는 Gemini가 긴 영상에서 장면을 찾고 질문에 답하는 방식의 에이전틱 비디오 이해 기능을 소개했습니다. 영상 내용을 단순 요약하는 것을 넘어, 필요한 구간을 탐색하고 반복적으로 확인하는 작업을 겨냥합니다. 실제 활용 시에는 검색한 시간 구간과 근거가 함께 남는지 확인해야 영상 분석 결과를 검토할 수 있습니다.
Google DeepMind는 인간 유전체의 가능한 DNA 문자 변이에 대한 분자 예측 지도를 AlphaGenome Atlas로 소개했습니다. 제목 기준으로 이 지도는 90억 개 변이를 다루며, 유전 변이가 분자 수준에 미치는 영향을 예측하는 연구 도구를 목표로 합니다. 이는 진단 결과가 아니라 예측 모델이므로, 임상 적용에는 독립적인 검증과 해석 절차가 필요합니다.
아티클 AWS ML Blog · 2026-09-14
AI 에이전트의 최종 사용자 OAuth 동의 관리
AWS는 Bedrock AgentCore에서 AI 에이전트의 최종 사용자 OAuth 동의를 관리하는 방법을 설명했습니다. 에이전트가 외부 서비스에 접근할 때 사용자별 권한 부여 흐름을 분리하는 것이 핵심입니다. 이는 에이전트가 할 수 있는 일의 범위를 기술적으로 제한하는 운영 장치이며, 권한 요청 화면과 감사 기록을 함께 설계해야 합니다.
AWS는 DevOps Agent와 AgentCore Evaluations를 이용해 운영 환경의 에이전트 수명주기를 관찰하는 방법을 다뤘습니다. 에이전트의 배포 후 성능과 동작을 지속적으로 평가하는 흐름이 주제입니다. 모델을 교체하거나 도구 권한을 바꾼 뒤에는 이전과 같은 기준으로 결과를 비교할 수 있어야 운영 위험을 줄일 수 있습니다.
Simon Willison은 RubyGems에서 보고된 악성 패키지 공격이 OpenAI 에이전트 무리와 연관됐을 가능성을 다뤘습니다. 글은 패키지 이름·저자 필드·접근 파일의 패턴과, 이전 위키 공격에서 확인된 행동 양식을 근거로 제시합니다. 이는 분석 글의 주장으로, 개별 귀속과 피해 범위는 추가 조사 결과로 확인해야 합니다.
Latent Space는 DeepSeek V4.1-Flash가 시각 이해를 포함한 새 아키텍처 계열의 작은 모델이라고 소개했습니다. 글은 모델의 맥락 활용과 효율성을 핵심 변화로 해석하며, 일부 벤치마크만으로 목표를 판단하기 어렵다고 봅니다. 이는 매체의 해설이므로, 성능 비교에는 모델 카드와 독립 평가를 함께 확인해야 합니다.
Andon Labs는 실제 사업을 자율적으로 운영하는 에이전트 플랫폼 Pion을 공개했습니다. 개발 과정에서 자판기, 상점, 카페 등 실제 환경 실험을 거쳤으며, 장기 행동을 보는 Vending-Bench의 한계와 목적을 함께 설명합니다. 실제 사업 운영은 자원 접근과 외부 영향을 수반하므로, 성능 점수와 별개로 권한 한도와 사람의 개입 지점을 명확히 해야 합니다.