2026년 9월 22일 · 읽는 시간 약 17분 · Hugging Face Daily Papers 4편 · arXiv 보강 0편 · RSS 뉴스·아티클 10건
AI 에이전트의 경쟁력은 ‘생성’보다 검증 가능한 실행에 있다
오늘의 논문과 현장 사례는 코드·화면·데이터를 다루는 에이전트가 실행 환경, 기억, 격리, 검증을 함께 갖춰야 한다는 점을 보여 줍니다.
오늘의 데일리 브리핑
에이전트 학습의 재료가 실행 가능한 코드와 환경으로 이동합니다. CodeMidas와 Grounded Skill Synthesis는 기존 코드에서 과제와 절차 지식을 뽑고, KAIST의 CURE는 서버 판단을 기기에 축적해 재사용합니다. 공통점은 모델을 다시 학습시키는 대신 검증 가능한 실행 기록을 자산으로 만든다는 점입니다. (CodeMidas, CURE)
화면을 보는 능력만으로는 실제 업무 자동화가 완성되지 않습니다. RecreationWorld는 GUI 탐색·구현·시각 검증을 한 과제로 묶고, Gemini의 에이전트 영상 이해는 필요한 장면만 선택합니다. 두 접근 모두 입력량을 줄이지만, 결과물을 자동 검증하는 장치가 있어야 신뢰할 수 있습니다. (RecreationWorld, Agentic Video)
장기 실행의 핵심은 기억과 접근권한의 관리입니다. EvoOntology는 이질적 데이터에 접근할 의미 계층을 갱신하고, Benchling은 테넌트별 실행을 격리해 DNS 유출 경로까지 막습니다. 기억을 늘리거나 도구 권한을 넓힐수록 평가와 격리를 함께 강화해야 합니다. (EvoOntology, Benchling)
비전문가에게 실용적인 기준은 ‘빠른 응답’보다 기록 가능한 검증입니다. Qwen3.8-LiveTranslate의 지연 단축과 Jev의 빠른 판단은 유용하지만, 통역의 정확성·결정의 편향은 별도 평가가 필요합니다. 자동화 도입 시에는 입력, 권한, 결과 검증을 같은 흐름에서 확인해야 합니다. (LiveTranslate, Jev)
Hugging Face Daily Papers
아래 4편은 2026년 9월 21일 Hugging Face Daily Papers 목록에서 확인했고, arXiv 초록으로 메타데이터를 교차 확인했습니다. 모두 최근 14일 이내 제출 논문이며 이전 보고서와 중복되지 않습니다.
Hugging Face Daily Papers · 2026-09-18 · Bowen Ye 외 N명 · HF 논문 페이지 · arXiv
기존 코드에서 코딩 에이전트용 강화학습 환경을 만들기
CodeMidas: Scaling Agentic Coding RL Environments from Code Itself
쉽게 말하면
이미 작동하는 프로그램의 기능을 이용해 AI가 연습할 과제와 채점기를 만드는 연구입니다. 이슈나 커밋처럼 일부 개발 기록에만 의존하지 않고, 코드 자체에서 검증 가능한 연습 환경을 넓히려 합니다.
논문은 무엇을 했나
코딩 에이전트의 강화학습에는 다양한 과제와 신뢰할 수 있는 검증기가 필요합니다. CodeMidas는 오픈소스 코드베이스의 구현 기능을 유일한 과제별 입력으로 받아 실행 가능한 환경으로 바꾸는 에이전트 파이프라인을 제안합니다. 기존 방식이 이슈와 커밋 같은 개발 산출물에 기대어 과제 범위가 제한된 문제를 겨냥합니다. 초록은 코드로부터 환경을 만드는 과정이 다양한 소프트웨어 작업으로 전이될 수 있다고 설명합니다.
핵심 근거
목표코딩 강화학습용 과제와 검증 환경의 범위를 넓히기
방법기존 코드의 구현 기능을 분석해 실행 가능한 RL 환경으로 변환
결과개발 기록에 덜 의존하는 환경 생성 경로를 제시
지표초록에서 단일 성능 수치를 제시하지 않았습니다
작동 흐름
1. 입력기존 코드베이스의 구현 기능
분석 →
2. 처리에이전트가 과제·검증 조건을 구성
실행 →
3. 산출물실행 가능한 RL 환경
평가 →
4. 다음 조치코딩 에이전트 학습·검증
초록 근거: 구현된 기능을 코드 자체에서 실행 가능한 강화학습 환경으로 변환하는 순서입니다.
Hugging Face Daily Papers · 2026-09-18 · Shuai Bai 외 N명 · HF 논문 페이지 · arXiv
GUI와 터미널을 오가는 컴퓨터 사용 에이전트의 검증 환경
RecreationWorld: Scalable and Verifiable Environments for Hybrid Computer-Use Agents
쉽게 말하면
AI가 화면을 둘러보면서 프로그램을 만들고, 만든 결과를 다시 눈으로 확인하게 하는 평가 환경입니다. 실제 디지털 업무는 클릭과 코드 작성이 섞여 있으므로 둘을 따로 시험하면 놓치는 부분이 생깁니다.
논문은 무엇을 했나
연구진은 그래픽 인터페이스 조작과 명령줄 개발이 분리돼 발전해 온 한계를 지적합니다. RecreationWorld에서는 실행 중인 참조 프로그램을 관찰한 뒤, 에이전트가 동작을 발견하고 구현하며 시각적으로 확인합니다. 프레임워크는 다섯 플랫폼을 다루며 정해진 작업 순서를 강제하지 않습니다. 초록은 이러한 재현 궤적으로 학습한 모델이 코딩과 혼합 컴퓨터 사용의 여러 분포 밖 벤치마크에서도 개선됐다고 보고합니다.
핵심 근거
목표GUI와 코드 작업을 함께 수행하는 에이전트의 검증 가능한 학습 환경 구축
방법참조 앱 탐색, 구현, 실행·시각 검증을 결합한 5개 플랫폼 환경
결과재현 기반 궤적 학습이 코딩·혼합 컴퓨터 사용으로 전이된다고 보고
지표초록은 여기서 단일 개선 수치를 제시하지 않았습니다
작동 흐름
1. 입력실행 중인 참조 앱
탐색 →
2. 처리GUI·코드 작업을 번갈아 수행
재현 →
3. 산출물동작하는 구현물
검증 →
4. 평가프로그램·시각 조건 확인
초록 근거: 참조 동작을 탐색하고 구현한 뒤 실행·시각 검증으로 확인하는 순서입니다.
Hugging Face Daily Papers · 2026-09-14 · Meiduo Chong 외 N명 · HF 논문 페이지 · arXiv
데이터 에이전트가 스스로 고치는 온톨로지 계층
EvoOntology: A Self-Evolving Ontology Layer for Data Agents
쉽게 말하면
표, 파일, 데이터베이스에 흩어진 정보를 AI가 찾기 쉽게 중간 안내 지도를 만드는 방법입니다. 이 지도는 한 번 만들어 두는 문서가 아니라, 에이전트가 실패한 흔적을 보고 검증을 통과한 수정만 받아들입니다.
논문은 무엇을 했나
이질적 데이터는 에이전트 밖에 있고, 에이전트는 열 이름이나 파일 경로처럼 제한된 도구 정보만 보는 ‘에이전트-데이터 간극’을 가집니다. EvoOntology는 스키마·내용·도구 계층을 MCP 서버로 묶어 에이전트가 실행 중에 질의하도록 합니다. 빌더 에이전트가 초기 온톨로지를 만들고, 상호작용 궤적의 원인 분석을 통해 수정안을 제시합니다. 수정은 보류 검증 세트의 짝 비교 평가를 통과해야만 반영됩니다.
핵심 근거
목표이질적 데이터에서 에이전트의 탐색 낭비를 줄이고 의미 기반 접근을 지원
방법MCP 서버형 온톨로지와 원인 분석 기반의 검증된 반복 수정
결과3개 데이터 에이전트 벤치마크와 4개 LLM 기반에서 강한 기준선보다 일관되게 우수했다고 보고
지표초록은 세부 수치 대신 일관된 우수성을 보고했습니다
작동 흐름
1. 입력표·파일·DB와 에이전트 궤적
구성 →
2. 처리스키마·내용·도구 계층 생성
수정 →
3. 산출물런타임 질의 가능한 온톨로지
검증 →
4. 평가짝 비교 통과 수정만 반영
초록 근거: 초기 구축 후 상호작용 궤적을 분석하고, 짝 비교 평가를 통과한 수정만 반영합니다.
Hugging Face Daily Papers · 2026-09-04 · Yongqi Tong 외 N명 · HF 논문 페이지 · arXiv
코드에서 실행 근거가 있는 에이전트 스킬을 합성하기
Grounded Skill Synthesis from Code at Scale for Agentic Intelligence
쉽게 말하면
AI가 다음 업무에 재사용할 절차 지식을 만들 때, 설명문이나 과거 대화만 보지 말고 실제 코드에 근거하자는 연구입니다. 코드에는 실행 가능한 증거가 있으므로, 그 절차가 실제 도구와 맞는지 확인하기가 더 쉽습니다.
논문은 무엇을 했나
재사용 가능한 스킬은 에이전트의 경험 밖 작업을 넓히는 절차 지식입니다. 기존의 궤적 기반 합성은 특정 환경에서 상호작용해야 하고, 문서 기반 스킬은 실행 근거나 검증이 약할 수 있습니다. 연구진은 소스 코드가 사전 에이전트 경험 없이도 실행 가능한 근거를 준다고 보고 이를 활용합니다. 논문은 코드 기반 스킬뱅크와 궤적·문서 유래 방식의 한계를 비교합니다.
핵심 근거
목표대규모 에이전트 스킬을 실행 근거와 함께 획득
방법소스 코드에서 절차 지식을 합성하고 재사용 가능한 스킬로 구성
결과궤적·문서 기반 방식의 검증 한계를 보완하는 경로를 제시
지표초록은 단일 수치를 제시하지 않았습니다
작동 흐름
1. 입력소스 코드의 실행 근거
추출 →
2. 처리절차 지식으로 합성
구성 →
3. 산출물재사용 가능한 스킬
활용 →
4. 다음 조치에이전트 작업 수행
초록 근거: 소스 코드의 실행 가능한 근거를 이용해 스킬을 합성하고 이후 작업에 재사용하는 순서입니다.
RSS 뉴스·아티클
국내 3건, 해외 4건, 블로그·Hacker News 후보 3건을 골랐습니다. 원문 HTML을 직접 확인했으며, MiMo와 Linear 두 건은 동적 페이지 구조 때문에 본문 상세를 추출하지 못해 카드에 제한을 표시했습니다. 공식 원문 이미지 3개를 로컬에 저장했습니다.
KAIST 연구진은 소형 기기 AI와 서버 모델을 연결하는 CURE 프레임워크를 소개했습니다. 기기가 먼저 답할 수 있는지 판단하고, 부족하면 축적한 서버 지식을 쓰며, 마지막에만 서버를 호출합니다. 이미지넷에서 정확도 82.43%를 보고하면서 기존 협업 방식 대비 서버 호출은 평균 55.61% 줄였고, 실제 비용·전력·장기 안정성은 추가 검증이 필요하다고 밝혔습니다.
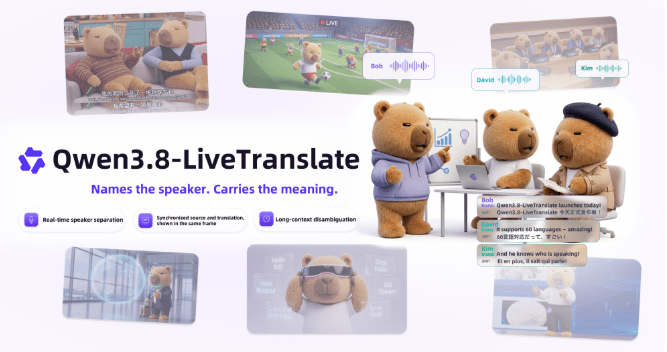
알리바바는 음성이 끝나기 전에 번역문과 번역 음성을 생성하는 Qwen3.8-LiveTranslate를 공개했습니다. 오디오와 텍스트를 한 흐름으로 엮는 구조를 사용하며, 기사 기준 LAAL 평균 지연은 2.8초에서 2.3초로 약 18% 감소했습니다. 60개 언어 입력과 29개 언어 음성 출력을 지원하며, 실제 회의에서의 오류율과 화자 전환 품질은 별도 검증이 필요합니다.
앤돈랩스는 이메일, 전화, 웹 브라우저, 금융 계좌 권한을 받아 기업 운영을 수행하도록 설계한 파이온을 공개했습니다. 앞선 자판기·소매점·카페 실험에서는 모델 발전과 함께 운영 능력이 개선됐지만, 실제 사업들은 아직 수익을 내지 못했다고 설명했습니다. 회사는 시뮬레이션과 현실의 차이, 비정상 행동 가능성을 인정하며 자동 모니터링을 우선 과제로 제시했습니다.
Google DeepMind는 자연스러운 음성 대화와 복잡 작업을 겨냥한 Gemini 3.8 Live 계열을 소개했습니다. 공식 설명에 따르면 이 모델은 97개 지원 언어를 대화 중 전환하고, 대화를 계속하면서 배경에서 도구와 API 호출을 수행합니다. Extended Thinking은 더 깊은 추론이 필요한 작업에서 말과 추론을 함께 진행하도록 설계됐으며, 업무별 정확도와 안전성은 사용 환경에서 따로 평가해야 합니다.
Google은 Gemini 3.7 Flash, 3.6 Flash, 3.5 Flash-Lite에 에이전트 기반 영상 이해 기능을 도입했습니다. 고정 프레임률로 전체 영상을 읽는 대신, 모델이 목적에 맞춰 볼 구간·속도·형식(프레임·오디오·자막)을 고릅니다. 회사는 토큰 사용량을 최대 88%, 비용을 최대 66% 줄이면서 정확도를 높였다고 밝혔으며, 절감 폭은 영상과 질의 유형에 따라 달라질 수 있습니다.
Benchling은 생명과학 고객별로 생성형 AI 코드 실행을 분리하기 위해 별도 계정과 인터넷 연결이 없는 VPC를 사용합니다. DNS 방화벽은 차단 목록, 허용 목록, 나머지 전부 차단의 세 단계 정책을 적용하고, 작업마다 제한된 임시 자격증명을 주입합니다. AWS 글은 하루 600회 이상 코드 실행, 주 250개 이상 테넌트에서 보안 사고와 테넌트 간 유출이 없었다고 보고하며, 구성 변경 뒤에도 유출 시뮬레이션을 CI에서 계속 검사합니다.
Simon Willison은 Jev가 자유 텍스트를 생성하는 대신, 비정형 상태를 받아 타입이 있는 확률적 결정을 반환하는 모델이라고 정리했습니다. 분류, 라벨 제안, 우선순위, 재정렬처럼 결과 형식이 정해진 작업에 적합하다고 봅니다. 다만 결과가 실수 하나로 나올 수 있어 왜 그런 판정을 내렸는지 설명하기 어려우며, 채용 순위처럼 편향 위험이 큰 용도에서는 평가가 더 중요하다고 지적했습니다.
RSS 후보 제목은 AI 코딩이 CI를 병목으로 만들자 Linear가 CI 흐름을 재설계한 사례를 다룹니다. 원문은 자바스크립트 렌더링 구조라 이 실행 환경에서 본문 상세를 신뢰성 있게 추출하지 못했습니다. 원문 상세 확인 불가
이미지·원문 확인 메모 공식 원문에서 확인한 대표 이미지 3개를 로컬 assets 폴더에 내려받았습니다. 모든 이미지에는 figure, 대체 텍스트, 한국어 캡션, 원문 링크를 넣었습니다. OpenAI V7은 HTTP 403이었고 MiMo·Linear는 동적 본문을 신뢰성 있게 추출하지 못해, 해당 카드와 요약에서 원문 상세 확인 불가를 표시했습니다.