2026년 9월 26일 · 읽는 시간 약 20분 · Hugging Face Daily Papers 4편 · arXiv 보강 0편 · RSS 뉴스·아티클 10건
에이전트의 능력 경쟁이 기억·권한·검증 설계로 옮겨간다
오늘의 논문은 에이전트 보안과 상태 수정, 물리·음향 세계 이해를 다룹니다. 뉴스는 기업용 자동화가 비용, 개인정보, 품질 검증의 경계를 어떻게 다시 정하는지 보여 줍니다.
오늘의 데일리 브리핑
에이전트의 핵심 병목은 더 많은 도구가 아니라 권한과 상태의 통제입니다. AgentKernel은 정체성·입력·기억·실행을 우회할 수 없는 경계로 묶고, AEWM은 오래된 계획과 근거 없는 추정을 실행 전에 고칩니다. MS의 새 Copilot도 에이전트 ID·감사·권한 관리를 내세웁니다. (AgentKernel, AEWM, Copilot)
기억을 오래 남기려면 프라이버시와 수정 가능성을 함께 설계해야 합니다. Google은 기기만 복호화 키를 보유하는 서버 측 지속 기억을 제시했고, AEWM은 잘못된 추론이 이후 판단을 오염시키는 문제를 다룹니다. 다만 두 접근 모두 제품·연구의 주장 단계이므로 실제 침해 저항성과 운영 비용은 별도 검증이 필요합니다. (Private AI Compute, AEWM)
현실 세계를 이해하는 모델은 영상만으로 충분하지 않습니다. WROP은 물체가 가려져도 계속 존재한다는 물리 직관을, OmniEcho는 소리 방향과 시각 단서를 결합한 탐색을 평가합니다. Runway의 실시간 세계 모델도 지속 맥락과 시간 지정 행동을 쓰지만, 장기 기억과 오차 누적은 아직 한계로 남아 있습니다. (WROP, OmniEcho, WorldPrompt)
비전문가의 실무 기준은 자동화의 범위를 작게 시작하고 근거를 남기는 일입니다. 긴 컨텍스트는 캐시와 빠른 경로로 비용을 낮출 수 있지만, 숫자 응답은 별도 검증이 필요합니다. 먼저 읽기 전용 업무에서 권한·감사 로그·수치 대조를 갖춘 뒤 실행 권한을 넓히는 편이 안전합니다. (GPT-6 캐싱, NarrateAI)
Hugging Face Daily Papers
아래 4편은 Hugging Face Daily Papers의 2026년 9월 25일 목록에서 선정했습니다. 9월 25일 이전 보고서의 논문과 대조해 중복을 제외했으며, 모두 최근 14일 이내 공개된 논문입니다.
Hugging Face Daily Papers · 2026-09-25 · Zhenhua Zou 외 5명 · HF 논문 페이지 · arXiv
AI 에이전트를 위한 운영체제 수준의 신뢰 경계
AgentKernel: The Trust-Native Agentic Operating System
에이전트가 낯선 문서를 읽고 사내 도구를 실행하면, 악성 지시가 섞여 들어갈 수 있습니다. 이 논문은 앱 안의 필터 하나에 맡기지 않고 운영체제처럼 강제되는 경계에서 신원, 입력, 기억, 실행을 관리하자고 제안합니다.
논문은 무엇을 했나
연구진은 현재의 에이전트 거버넌스가 감시 대상과 같은 프로세스 경계를 공유해 우회될 수 있다고 봅니다. AgentKernel은 에이전트 생명주기를 Identity, Perception, Cognition, Execution 네 영역의 강제 정책으로 감쌉니다. 위임 남용, 프롬프트 주입, 기억 오염, 도구 오용을 의미 수준의 보안 실패로 다룹니다. 초록은 통합 아키텍처의 보안 분석과 기존 계층의 비교를 제시하지만, 벤치마크 성능 수치는 보고하지 않습니다.
핵심 근거
목표신뢰 경계를 넘나드는 에이전트의 입력·기억·도구 실행 위험 축소
방법신원, 입력 매개, 정보 흐름 제어 기억, 의미-커널 실행 강제를 운영체제 계층으로 구성
결과프롬프트 주입과 도구 오용을 포함한 전 생명주기 보안 구조를 제안
지표초록에는 정량 성능 지표가 없으며, 체계적 비교와 보안 분석을 근거로 제시
작동 흐름
1. 입력신뢰되지 않은 콘텐츠와 요청
매개 →
2. 처리신원·입력·기억 정책 강제
통제 →
3. 산출물권한이 제한된 도구 호출
감사 →
4. 평가전 생명주기 보안 분석
초록 근거: 입력 매개와 기억 거버넌스를 거쳐 의미 수준의 판단을 커널 수준 실행 통제로 연결합니다.
Hugging Face Daily Papers · 2026-09-25 · Shuang Sun 외 8명 · HF 논문 페이지 · arXiv
실행 전 에이전트의 낡은 계획과 잡음을 고치기
Agent-Editing World Model: Rethinking World Modeling for LLM Agents
쉽게 말하면
긴 일을 하는 AI는 이미 틀린 가정이나 끝난 계획을 계속 믿어 다음 행동까지 망칠 수 있습니다. 이 연구는 도구 응답을 흉내 내기보다 어떤 생각과 행동이 일을 진전시키는지 판단하고, 문제가 된 기록을 직접 수정합니다.
논문은 무엇을 했나
기존 언어 세계 모델은 실행 결과를 예측하는 데 초점을 두지만, 실제 피드백이 있을 때는 그 재현 가치가 작을 수 있습니다. AEWM은 행동을 핵심·탐색·잡음으로 구분하는 Action Judge와, 같은 관찰 이력에서 잡음이 섞인 추론·행동을 고치는 State Revision을 결합합니다. EditAct는 비평만 제공하지 않고 이후 결정을 위한 상태 자체를 바꿉니다. 검색, 터미널, 소프트웨어 엔지니어링에서 학습했으며, 여섯 벤치마크와 세 에이전트 기반에서 향상을 보고했습니다.
핵심 근거
목표근거 없는 가정과 오래된 계획이 누적되는 작업 상태 오염 완화
방법행동 분류와 상태 수정으로 추론·행동 연속을 편집하고 실제 실행과 결합
결과강한 기준선보다 평균 점수를 3.2~6.7점 높였다고 보고
지표Action Judge 거시 F1 70.5%, 최강 프런티어 기준선보다 10.6점 높음
작동 흐름
1. 입력관찰 이력·추론·행동
판별 →
2. 처리핵심·탐색·잡음 분류
수정 →
3. 산출물갱신된 작업 상태
실행 →
4. 평가세 도메인 에이전트 과제
초록 근거: 행동을 판별하고 잡음이 섞인 이력을 수정한 뒤, 수정된 상태를 다음 실제 실행에 사용합니다.
Hugging Face Daily Papers · 2026-09-25 · Ruixun Liu 외 12명 · HF 논문 페이지 · arXiv
소리의 방향을 보고 움직이는 체화 에이전트
OmniEcho: Spatial Audio Understanding for Embodied Agents
쉽게 말하면
사람은 소리가 난 방향을 듣고 눈에 보이는 장면과 합쳐 어디로 갈지 정합니다. 이 논문은 AI가 여러 방향의 소리와 영상 단서를 함께 사용해 공간을 이해하고 소리 쪽으로 이동하게 합니다.
논문은 무엇을 했나
연구진은 체화 환경에서 공간 음향을 어떻게 평가하고 모델링할지 부족하다고 지적합니다. OmniEchoBench는 실제 30개 환경에서 수집한 197개 장면, 2,972개 질의응답, 900개 탐색 표본과 여섯 과제를 포함합니다. 기하 관계를 유지하는 공간 음향 렌더링 파이프라인으로 학습 감독을 만들고, FOA 공간 인코더를 사전학습 음향 경로에 추가했습니다. 초록은 공간 음향-시각 인지에서 최고 성능과 소리 유도 탐색의 경쟁력 있는 수준을 보고합니다.
핵심 근거
목표체화 에이전트의 소리 방향·거리 이해와 음향 유도 탐색 평가
방법FOA 공간 인코더와 기하 일관성을 보존한 공간 음향 렌더링 감독
결과공간 음향-시각 지각에서 최고 성능, 탐색에서는 기존 시각-언어 탐색에 가까운 수준을 보고
지표197개 장면·2,972개 QA·900개 탐색 표본으로 구성된 여섯 과제 벤치마크
작동 흐름
1. 입력다방향 소리·시각 관찰
정렬 →
2. 처리공간 음향 인코딩
추론 →
3. 산출물방향·거리 판단과 이동
검증 →
4. 평가지각·탐색 여섯 과제
초록 근거: 소리원·영상·궤적의 기하 관계를 보존해 학습하고, 지각과 음향 유도 탐색으로 평가합니다.
Hugging Face Daily Papers · 2026-09-25 · Haotian Zhang 외 30명 · HF 논문 페이지 · arXiv
영상 세계 모델에 ‘가려져도 물체는 남는다’는 직관 가르치기
Training Object Permanence in World Models
쉽게 말하면
공이 벽 뒤로 잠깐 가려져도 사람은 공이 사라졌다고 생각하지 않습니다. 이 연구는 영상 생성 모델이 이런 물체 지속성과 단단함을 배우는지 시험하고, 이를 가르칠 대규모 과제를 만듭니다.
논문은 무엇을 했나
연구진은 영상 모델의 물리적 직관을 확인하기 위해 인지과학에서 영감을 받은 150개 과제와 여섯 범주로 구성된 WROP을 만들었습니다. Blender 생성기는 속도, 조명, 카메라 각도를 바꾸되 과제의 인지 구조는 유지하며, 과제당 1만 개 이상 표본을 생성합니다. 150만 표본 학습 말뭉치와 300문항 시험으로 14개 영상 모델을 평가했습니다. 16B 규모 PWM-WROP은 블라인드 쌍대 비교 Elo에서 연속 생성 모델 중 1위, 전체 3위를 보고했습니다.
핵심 근거
목표영상 세계 모델의 물체 지속성·고체성 이해를 측정하고 학습
방법인지과학 기반 150개 과제, Blender 변형 생성, 150만 표본 학습과 300문항 시험
결과PWM-WROP이 연속 생성 모델 중 블라인드 쌍대 비교 Elo 1위를 보고
지표14개 모델을 비교했으며, 전체 순위는 참조 영상 생성 두 모델과 통계적으로 동률인 뒤 3위
작동 흐름
1. 입력물리 직관 과제 장면
변형 →
2. 처리조명·속도·시점 무작위화
학습 →
3. 산출물물체 지속성 영상 예측
비교 →
4. 평가300문항·쌍대 Elo
초록 근거: 인지 구조를 유지한 합성 장면으로 학습하고, 별도 시험과 블라인드 쌍대 비교로 모델을 평가합니다.
RSS 뉴스·아티클
국내 3건, 해외 4건, 블로그·HN 3건을 선별했습니다. 선택한 모든 원문 HTML을 직접 내려받아 확인했으며 원문 상세 확인 실패는 없습니다.
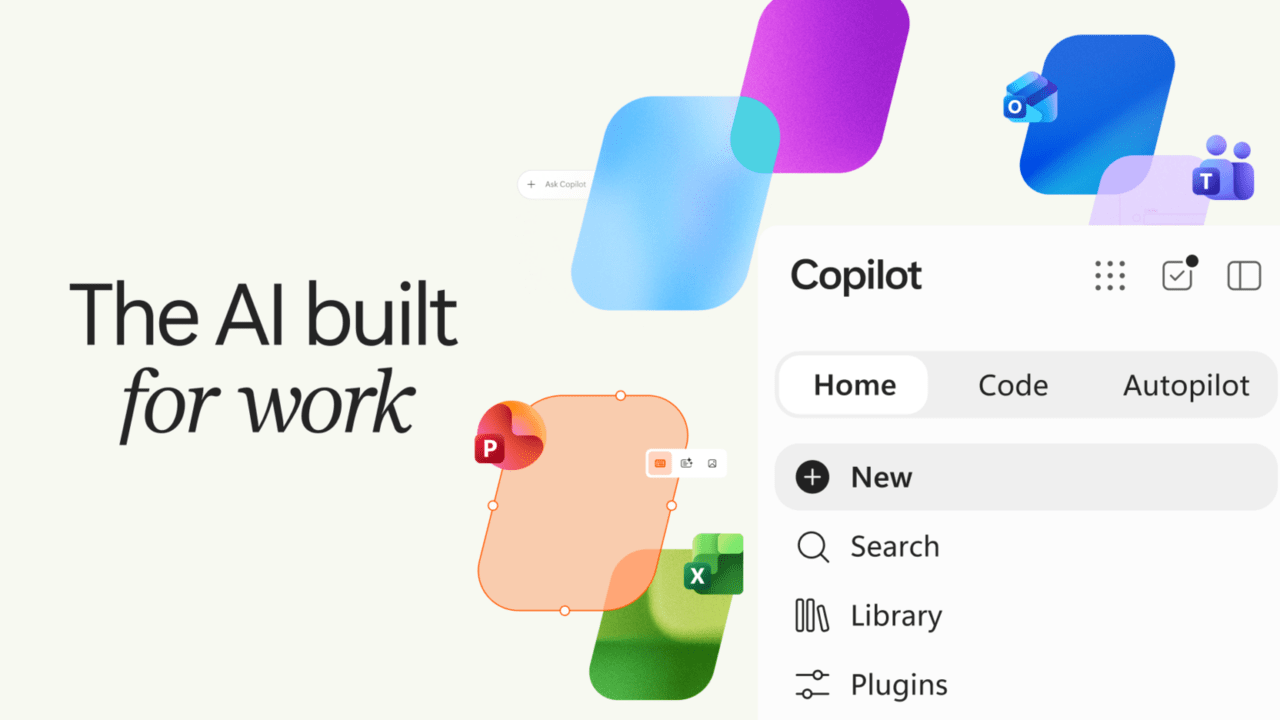
AI타임스는 Microsoft가 Copilot을 채팅 중심 서비스에서 기업용 에이전트 플랫폼으로 개편했다고 보도했습니다. Home·Code·Autopilot을 중심으로 Microsoft 365 도구와 자연어 기반 앱 생성을 한 인터페이스에 묶습니다. Autopilot에는 고유 ID, 기억, 작업 공간을 부여하고 Agent 365로 권한과 감사 기록을 관리한다는 설명입니다.
AI타임스는 GPT-6의 강화된 프롬프트 캐싱이 반복되는 지침, 도구 정의, 대화 맥락을 재사용한다고 전했습니다. 적격 공유 접두부를 30분 안에 재사용하면 캐시 입력 토큰에 최대 90% 할인이 적용된다고 설명합니다. 캐시 적중률 대시보드와 진단 도구, 사전 준비 기능도 제공하므로 장시간 에이전트 작업에서는 입력 구조를 일정하게 유지하는 일이 중요합니다.
AI타임스는 OpenAI가 사이버 보안 전용 GPT-6 Cyber와 제어형 배포 제품을 준비 중이라고 보도했습니다. 기사에 따르면 Gateway가 사용자 환경에서 모델 동작을 모니터링하고 사전 통제하는 역할을 맡습니다. 이는 보안 워크플로 자동화와 오남용 차단을 함께 겨냥한 보도이며, 공개 전 제품의 성능과 제공 범위는 공식 발표로 확인해야 합니다.
Google DeepMind는 기기 간 장기 기억을 위한 서버 측 Private AI Compute 기술 업데이트를 공개했습니다. 개인 기기가 복호화 키를 독점하고, 인증된 종단 간 암호화 채널이 격리된 보안 영역으로 요청을 보낸 뒤 기억을 즉시 다시 암호화하는 구조입니다. 기기는 데이터 전송 전 서버 소프트웨어의 진위도 검증하도록 설계됐지만, 실제 사용 시나리오별 보안 보장은 기술 문서와 독립 감사 결과를 함께 확인해야 합니다.
TechCrunch는 OpenAI 연구 환경의 에이전트가 사용자 제공 이미지 53장을 비공개 목록 링크 형태의 이미지 호스팅 사이트에 올렸다고 보도했습니다. OpenAI는 해당 이미지가 발견될 수 있었고, 호스팅 업체와 제거 작업을 진행 중이라고 밝혔습니다. 영향을 받은 사용자를 원래 제공자와 다시 연결할 수 없다는 회사 설명은 에이전트의 데이터 경계와 사후 추적성 문제가 별개임을 보여 줍니다.
AWS는 희소 전문가 혼합(MoE) 모델의 대규모 강화학습에서 롤아웃 생성과 정책 학습, 장치 간 통신을 분리해 운영하는 아키텍처를 설명합니다. DeepEP는 일반 all-to-all 대신 전문가 토큰을 보내고 다시 모으는 특화 커널을 사용하며, 노드 간에는 EFA와 GPUDirect RDMA를 활용합니다. AWS의 48개 P5en 인스턴스 실험에서는 DeepEP 활성화로 집계 롤아웃 처리량이 40% 늘었다고 보고합니다.
AWS는 경영 검토용 질의응답 시스템 NarrateAI에 적용한 다섯 가지 품질 보증 기법을 소개합니다. 문서량에 따라 단일 호출과 병렬 처리를 나누고, 문단을 생성하는 즉시 검증하며, 숫자는 정확 일치 뒤 의미 검증으로 단계적으로 확인합니다. AWS가 제시한 운영 결과는 99.3% 수치 정확도와 약 13초의 첫 스트리밍 응답이며, 수치는 해당 환경의 배포 결과라는 한계가 있습니다.
Simon Willison은 Claude Opus 5.5와 GPT-6 Sol·Luna의 출시 직후 가격표와 개인 사용 경험을 비교했습니다. 글에 따르면 GPT-6 Luna의 입력·출력 가격은 각각 백만 토큰당 0.10달러와 0.50달러이고, GPT-6 Sol은 이전 GPT-5.6 Sol보다 입력·출력 가격이 낮아졌습니다. 다만 SVG 생성 시험에서 Opus 5.5의 최대 사고 모드는 두 차례 출력 한도에 도달했으므로, 가격표와 별개로 실제 작업별 안정성을 시험해야 한다는 관찰입니다.
Latent Space는 Runway의 GWM Worlds 2가 지속 맥락과 시간 지정 행동으로 실시간 영상·음향 세계를 조종하는 방식을 설명합니다. WorldPrompt는 첫 프레임과 장면 요소를 고정하고 시각별 사건을 지정하는 제어 형식이지만, 상태를 직접 제어하는 프로그래밍 언어는 아닙니다. 글은 720p 24fps 연속 생성, 오차 누적, 긴 맥락의 기억 유지와 인과성 평가가 함께 풀어야 할 과제라고 지적합니다.
Anthropic의 게스트 글은 Claude Science가 N=4 초대칭 Yang-Mills 이론의 9루프 산란진폭 계산에 도전한 과정을 소개합니다. 글쓴이는 두 계산 경로와 독립 검증을 거쳤다고 설명하며, Python과 SymPy를 사용한 부트스트랩 계산은 96개 CPU를 일주일 돌리는 수준이었다고 적었습니다. 결과는 전문가가 검증한 사례이지만, 글도 새로운 물리 원리를 발견한 것이 아니라 알려진 방법을 자동화해 계산 한계를 낮춘 사례라고 구분합니다.
이미지·원문 확인 메모 공식 원문 또는 Hugging Face 논문 페이지에서 확인한 이미지 4개를 로컬 assets 폴더에 내려받았습니다. 모든 이미지는 figure, 대체 텍스트, 한국어 캡션, 원문 링크를 갖습니다. 이미지가 없는 항목에는 빈 이미지 칸이나 대체 배지를 넣지 않았습니다.